Function Call 是什么

大模型的 Function Call(函数调用) 属于一种使大语言模型(LLM)依据用户指令调用外部函数或工具的技术,借助模型的理解能力与外部工具的精确性相结合,达成更为繁杂、更具动态性的任务处置。其核心要点如下:

定义

Function Call可让大模型基于用户的自然语言输入,识别意图并触发预先设定的外部函数或工具,把自然语言转化为结构化的参数传送给函数,最后整合函数返回的结果以生成用户能够理解的回应。

原理

  • 语义理解:模型解析用户输入,判定是否有调用函数的必要。
  • 函数匹配:从预先定义的函数库中选取适宜的工具(诸如天气查询、数学计算等)。
  • 参数生成:把用户描述转换为函数所需的参数格式(例如 {num:1.4})。
  • 执行整合:调用外部工具获取结果,进而生成自然语言的答复。

作用

突破大模型原生限制

  • 实时数据获取:例如查询天气、股票等动态信息(大模型自身知识库为静态的)。
  • 精准计算:处理像数学运算、数据分析这类需要高度准确性的任务(如计算平方、绝对值)。
  • 私域知识扩展:连接数据库、知识图谱等私有数据源,以解决特定领域的问题。

增强功能多样性

  • 支持复杂操作:像发送邮件、控制智能设备、自动化办公任务等。
  • 提升交互效率:用户无需学习特定的命令语法,使用自然语言就能触发复杂功能。

提升安全性与合规性

  • 敏感数据隔离:由外部工具处理隐私信息(如支付、身份验证),防止暴露给大模型。

使用方法

步骤一:定义外部函数

依据需求编写函数,例如:

1
2
3
# 示例:数学平方计算函数 
def calculator_square(num: float) -> float:
return num ** 2

步骤二:注册函数给大模型

向模型阐述函数的功能、参数以及使用场景(需符合模型要求的格式,如JSON Schema):

1
2
3
4
5
6
7
8
9
{
"name": "calculator_square",
"description": "计算一个数的平方",
"parameters": {
"type": "object",
"properties": {"num": {"type": "number"}},
"required": ["num"]
}
}

步骤三:用户提问触发函数调用

用户输入自然语言指令(如“计算1.4的平方”),模型判定需调用函数后,生成参数并返回:

1
2
3
4
5
6
{
"function_call": {
"name": "calculator_square",
"arguments": "{num: 1.4}"
}
}

步骤四:执行函数并返回结果

开发者解析参数,执行函数后将结果返回给模型,最终生成用户友好的回答:

1
1.4的平方是1.96。 

案例

下面使用 OpenAI Python 客户端实现 Function Call,通过一个简单的场景来演示:查询某个城市的天气情况。假设我们有一个外部函数 get_current_weather,它会调用一个天气 API 并返回结果。

注意事项

  • 函数安全性:需要对参数进行严格校验,防止恶意输入(如SQL注入)。
  • 模型适配:不同模型(如GPT - 4、GLM - 4)的Function Call接口可能存在差异,需参照官方文档。
  • 错误处理:模型可能会误选函数或者生成错误参数,需要设计容错机制(如重试或者提示用户澄清)。

依赖

1
pip install openai

函数定义

先定义一个外部函数 get_current_weather,它将调用一个天气 API(例如 OpenWeatherMap API)来获取实时天气数据。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
import requests

def get_current_weather(location: str, unit: str = "metric"):
"""
调用天气 API 获取当前天气
:param location: 城市名称
:param unit: 温度单位(metric 表示摄氏度,imperial 表示华氏度)
:return: 天气数据
"""
api_key = "YOUR_OPENWEATHERMAP_API_KEY"
url = f"http://api.openweathermap.org/data/2.5/weather?q={location}&units={unit}&appid={api_key}"
response = requests.get(url)
data = response.json()
return {
"temperature": data["main"]["temp"],
"description": data["weather"][0]["description"]
}

使用 OpenAI 的 Function Call

接下来,我们将使用 OpenAI 的 Python 客户端来实现 Function Call。假设我们已经有一个 OpenAI 的 API 密钥,并且启用了 Function Call 功能。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
import openai

# 设置 OpenAI API 密钥
openai.api_key = "YOUR_OPENAI_API_KEY"

# 定义 Function Call 的函数
def get_current_weather(location: str, unit: str = "metric"):
"""
调用天气 API 获取当前天气
:param location: 城市名称
:param unit: 温度单位(metric 表示摄氏度,imperial 表示华氏度)
:return: 天气数据
"""
api_key = "YOUR_OPENWEATHERMAP_API_KEY"
url = f"http://api.openweathermap.org/data/2.5/weather?q={location}&units={unit}&appid={api_key}"
response = requests.get(url)
data = response.json()
return {
"temperature": data["main"]["temp"],
"description": data["weather"][0]["description"]
}

# 定义 Function Call 的参数
functions = [
{
"name": "get_current_weather",
"description": "获取指定城市的当前天气",
"parameters": {
"type": "object",
"properties": {
"location": {
"type": "string",
"description": "城市名称"
},
"unit": {
"type": "string",
"description": "温度单位(metric 或 imperial)",
"default": "metric"
}
},
"required": ["location"]
}
}
]

# 用户输入
user_input = "北京今天的天气如何?"

# 调用 OpenAI API,启用 Function Call
response = openai.ChatCompletion.create(
model="gpt-4",
messages=[
{"role": "user", "content": user_input}
],
functions=functions,
function_call="auto" # 自动决定是否调用函数
)

# 检查是否需要调用函数
if response.choices[0].finish_reason == "function_call":
function_args = response.choices[0].message.function_call.arguments
function_name = response.choices[0].message.function_call.name

# 调用外部函数
if function_name == "get_current_weather":
weather_result = get_current_weather(
location=function_args["location"],
unit=function_args.get("unit", "metric")
)

# 将结果返回给模型
second_response = openai.ChatCompletion.create(
model="gpt-4",
messages=[
{"role": "user", "content": user_input},
{"role": "assistant", "content": response.choices[0].message.content},
{"role": "function", "name": function_name, "arguments": function_args},
{"role": "function", "name": function_name, "content": weather_result}
]
)
print(second_response.choices[0].message.content)
else:
print(response.choices[0].message.content)

通过Function Call,大模型从“纯文本生成器”晋升为“智能调度中心”,极大地拓展了应用范围。开发者可借助开源框架(如LangChain)快速集成此功能。

当全球电影票房榜单长期被好莱坞超级英雄和科幻巨制“统治”时,一部来自中国的动画电影正以雷霆之势改写历史——截至2025年2月,现象级国漫《哪吒之魔童闹海》全球票房突破17.7亿美元(约合人民币115亿元),距离第十名的《狮子王》(16.7亿美元)仅一步之遥。这不仅是中国电影工业的里程碑,更标志着东方文化叙事在全球主流市场的强势突围。


哪吒之魔童闹海

一、票房狂飙:从“国漫之光”到“世界顶流”

自2024年暑期档上映以来,《哪吒之魔童闹海》持续刷新纪录:

  • 国内票房:以68.2亿元超越前作《哪吒之魔童降世》(50.35亿元),登顶中国影史动画电影冠军;
  • 海外征程:北美首周票房突破4200万美元,创华语动画电影新纪录;东南亚多国单日票房超越《蜘蛛侠:纵横宇宙》;
  • 长尾效应:凭借口碑发酵,上映半年后仍稳居全球周票房前五,打破“动画电影生命周期短”的行业魔咒。

对比冲击:若成功跻身全球前十,哪吒将成为榜单中唯一非英语、非好莱坞出品的电影,与《阿凡达》《复仇者联盟》同列,改写全球影史格局。


数据来源

猫眼电影,全球影史票房榜

二、文化破壁:东方神话的全球化表达

《哪吒之魔童闹海》的成功绝非偶然,其背后是文化内核与工业技术的双重突破:

  • 叙事革新:颠覆传统哪吒故事,以“反抗天命”为核心,融合现代青年价值观,引发全球Z世代共鸣;
  • 视觉革命:2000余个特效镜头打造“水墨粒子”技术,蓬莱仙岛、四海龙宫等场景展现东方美学极致表达;
  • 全球发行:联合Netflix、索尼影业定制多语言版本,海外版台词本土化率达70%,规避“文化折扣”。

专家点评:

“这部电影证明,中国故事不需要‘讨好’西方审美,真正的好内容自带穿透力。”
——北京大学影视研究中心主任 张颐武


三、产业启示:中国电影工业化的新坐标

《哪吒》系列的成功,为中国电影产业注入强心剂:

  • 技术跃迁:主创团队“可可豆动画”自主研发的AI渲染系统,将制作效率提升40%,成本降低25%;
  • 产业链升级:衍生品收入超18亿元,覆盖潮玩、游戏、主题乐园,构建IP生态闭环;
  • 人才储备:影片带动全国动画专业报考人数增长63%,杭州、成都等地涌现十余家动画制作新势力。

数据印证:2024年中国动画电影市场规模达318亿元,同比增长89%,占全球市场份额从5%跃升至22%。


四、未来展望:中国IP的“封神宇宙”启航

《哪吒之魔童闹海》的全球突围,只是中国电影新纪元的开端:

  • 系列化开发:彩条屋影业已官宣《姜子牙2》《杨戬》等作品,构建“封神动画宇宙”;
  • 技术输出:中国动画渲染软件“太极”获迪士尼、皮克斯采购订单,打破海外技术垄断;
  • 文化共振:外媒预测,2030年前中国将诞生3-5部全球票房超20亿美元的“文化符号级”电影。

结语
当哪吒脚踏风火轮冲向全球票房前十,这不仅是数字的超越,更是一场文化自信的宣言。从“国漫崛起”到“世界共情”,中国电影正以独有的东方智慧,在好莱坞主导的全球影业版图中开辟新航道。下一个十年,或许我们终将见证:属于中国的“超级英雄”,站在世界舞台中央。

阿里云函数计算(FC)提供了CPU和GPU 2种运行环境,支持配置CPU核数,磁盘容量,内存大小,以及函数执行超时时间等参数,仅在使用时付费。

CPU 环境

可以直接通过代码部署,将代码放到云效,编写配置来部署。可使用’层’管理依赖,将除代码以外的依赖放到层中,在部署时选择层即可。

创建函数配置如下:

创建函数

配置文件

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
edition: 1.0.0
name: my-framework-app
access: default
services:
framework:
component: fc
props:
region: cn-shenzhen
service:
name: yolo
function:
name: yolo-cpu
description: Initialize
runtime: custom.debian10
environmentVariables:
PATH: >-
/var/fc/lang/python3.10/bin:/usr/local/bin/apache-maven/bin:/usr/local/bin:/usr/local/sbin:/usr/local/bin:/usr/sbin:/usr/bin:/sbin:/bin:/usr/local/ruby/bin:/opt/bin:/code:/code/bin
PYTHONPATH: /opt/python:/code
LD_LIBRARY_PATH: >-
/code:/code/lib:/usr/local/lib:/opt/lib:/opt/php8.1/lib:/opt/php8.0/lib:/opt/php7.2/lib
layers:
- acs:fc:cn-shenzhen:xxx我的账号idxxx:layers/fastapi/versions/1
- acs:fc:cn-shenzhen:xxx我的账号idxxx:layers/yolo/versions/1
# 依赖库,官方opencv层 libGL.so
- acs:fc:cn-shenzhen:official:layers/Python310-Opencv4x/versions/2
memorySize: 1024
cpu: 1
timeout: 60
codeUri: ./
diskSize: 10240
caPort: 8000
customRuntimeConfig:
command:
- python3
args:
- main.py
triggers:
- name: httpTrigger
type: http
config:
authType: anonymous
methods:
- GET
- POST
- PUT
- DELETE
- HEAD
- PATCH

层

这里使用3个层,一个包含yolo的依赖,一个包含opencv的依赖(官方有提供),一个包含fastapi等构建api需要的依赖。
这里分层的原因是阿里云的层最多支持500MB,太大的依赖必须分割.

层

创建层

python的依赖可以使用requirements.txt来构建

层]

创建yolo层时一致报错空间不足

这是由于yolo包ultralytics安装时默认会按照GPU版本的依赖包括cuda,torch等,而这些依赖太大导致层的空间不足.

从github yolo官方仓库找到一个Issue,里面有如何安装cpu版本的解决方法,参见:CPU-only version of ultralytics

具体来说就是使用pip安装时,添加一行配置

1
2
--extra-index-url https://download.pytorch.org/whl/cpu
ultralytics

GPU 环境

当前必须使用Docker容器镜像部署,需要执行构建镜像推送到阿里云容器镜像服务,然后在FC中选择镜像来创建函数,将所有依赖都放在镜像中.

使用Dockerfile构建,在阿里云上由于Dockerhub访问不了,国内一些镜像源访问不了,可以在外边构建好镜像在上传到阿里云的容器镜像服务中.

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
# 网络正常情况下可以构建成功,国内需要设置代理之类的才行
FROM python:3.11-slim

# 设置工作目录
WORKDIR /app

# 复制项目文件
COPY . .

# 安装系统依赖
RUN apt-get update && apt-get install -y \
libgl1-mesa-glx \
libglib2.0-0 \
git \
&& rm -rf /var/lib/apt/lists/*

# 安装Python依赖 使用镜像
RUN pip install --no-cache-dir -r requirements.txt

# 设置启动命令
CMD ["python", "main.py"]

背景

数据误删除,需要恢复,使用阿里云RDS mysql 8.0,已开启binlog,且是ROW模式

binlog日志模式

日志模式 说明 适用场景 优缺点
STATEMENT 记录执行的 SQL 语句。 简单的应用,数据修改操作较少,且不涉及存储过程、函数等复杂操作。 优点:日志文件相对较小,复制速度快。缺点:对于包含函数、存储过程、用户自定义变量的语句,可能无法正确地进行二进制日志复制;存在安全风险(可能泄露敏感信息)。
ROW 记录每一行数据的变化 (INSERT, UPDATE, DELETE)。 复杂的应用,数据修改操作频繁,需要保证数据一致性。 优点:能够精确地复制数据,避免 STATEMENT 模式下的安全风险和不兼容问题。缺点:日志文件相对较大,复制速度相对较慢。
MIXED 混合模式,MySQL 会自动选择 STATEMENT 或 ROW 模式。 大多数应用场景,MySQL 会根据实际情况选择最优的模式。 优点:兼顾了 STATEMENT 和 ROW 模式的优点,在大多数情况下都能取得较好的性能和一致性。缺点:MySQL 的选择机制可能并不总是最佳的,需要根据实际情况进行调整。
NO_BINLOG_EVENTS 不记录任何二进制日志事件。 不进行二进制日志复制的场景,例如一些只读的副本。 优点:不产生 binlog 文件,节省磁盘空间。缺点:无法进行二进制日志复制,无法进行数据恢复。

补充说明:

  • gtid (全局事务ID) 的使用与 binlog 模式无关,但它可以显著提高复制的效率和可靠性。 建议在任何模式下都开启 gtid 模式。
  • 选择合适的 binlog 模式需要根据具体的应用场景和数据特点进行权衡。 如果数据修改操作比较复杂,或者需要保证数据的精确复制,则应选择 ROW 模式;如果数据修改操作比较简单,且性能是主要考虑因素,则可以选择 STATEMENT 模式;MIXED 模式则适合大多数情况。
  • MySQL 8.0 及以后版本,默认使用 ROW 模式。

步骤

下载binlog

可以使用命令查看mysql中的binlog日志文件

1
SHOW BINARY LOGS;
Log_name File_size Encrypted
binlog.0000062 1,074,523,920 No
binlog.0000063 598,800,601 No
binlog.0000064 311,410 No
binlog.0000065 180 No
binlog.0000066 180 No
binlog.0000067 180 No
binlog.0000068 180 No
binlog.0000069 180 No
binlog.0000070 792 No
  • Log_name 列表示日志文件的名称。
  • File_size 列表示每个日志文件的大小(以字节为单位)。
  • Encrypted 列表示该日志文件是否被加密。

在阿里云RDS实例页面下载日志备份,操作如下:

阿里云工作台 >> 云数据库RDS版 >> 找到相关实例 >> 进入管理界面 >> 找到备份恢复 >> 基础备份列表 >> 日志备份 >> 选择相应时间段的biglog

下载binlog

如果日志文件还没有写盘,在阿里云控制台看不到,想要提前结束当前的日志写文件可以执行如下操作:

1
FLUSH LOGS;

解析

需要使用mysql工具解析,没有安装可使用下面的命令安装mysql 8.0的工具

1
sudo apt install mysql-server-core-8.0                                                                            

解析:

1
mysqlbinlog -vv --base64-output=DECODE-ROWS mysql-bin.0000062 > /tmp/binlog/mysql-bin-0000062.log

解析后就可以使用grep等工具查询相应的sql来恢复数据了

批量解析

如果有多个binlog文件,可以使用下面的命令批量解析,放到bash脚本中执行

1
2
3
for file in mysql-bin.*; do
mysqlbinlog -vv --base64-output=DECODE-ROWS "$file" > "/tmp/binlog/mysql-bin.${file##*.}.log"
done

搜索

如下,有一次误删除日志,需要再多个文件中搜索,使用grep命令查询

1
2
3
4
## 多次过滤,先找DELETE操作,再过滤出对应表的操作,最后找到指定行的(这里通过@1=7785472即表id),使用awk输出所在文件名
find . -name "*.log" -print0 | while IFS= read -r -d $'\0' file; do
grep 'DELETE' -B30 -A30 "$file" | grep 'example_table' -B30 -A30 | grep '@1=7785472' -B1 -A30 | awk -v file="$file" '{print file ": " $0}'
done

效果如下:

1
2
3
4
5
6
7
./mysql-bin.002563.log: ### WHERE
./mysql-bin.002563.log: ### @1=7785472 /* INT meta=0 nullable=0 is_null=0 */
./mysql-bin.002563.log: ### @2=1 /* INT meta=0 nullable=1 is_null=0 */
./mysql-bin.002563.log: ### @3=100 /* INT meta=0 nullable=1 is_null=0 */
./mysql-bin.002563.log: ### @4=140000 /* INT meta=0 nullable=1 is_null=0 */
./mysql-bin.002563.log: ### @5=140000 /* INT meta=0 nullable=1 is_null=0 */
./mysql-bin.002563.log: ### @6=140000 /* INT meta=0 nullable=1 is_null=0 */

日志:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
### DELETE FROM `example_db`.`example_table`
### WHERE
### @1=7785472 /* INT meta=0 nullable=0 is_null=0 */
### @2=1 /* INT meta=0 nullable=1 is_null=0 */
### @3=100 /* INT meta=0 nullable=1 is_null=0 */
### @4=140000 /* INT meta=0 nullable=1 is_null=0 */
### @5=140000 /* INT meta=0 nullable=1 is_null=0 */
### @6=140000 /* INT meta=0 nullable=1 is_null=0 */
### @7=0 /* INT meta=0 nullable=1 is_null=0 */
### @8=0 /* INT meta=0 nullable=1 is_null=0 */
### @9=7820 /* INT meta=0 nullable=1 is_null=0 */
### @10='' /* VARSTRING(1020) meta=1020 nullable=1 is_null=0 */
### @11=0 /* INT meta=0 nullable=1 is_null=0 */
### @12='测试' /* VARSTRING(512) meta=512 nullable=1 is_null=0 */
### @13='' /* VARSTRING(1020) meta=1020 nullable=1 is_null=0 */
### @14=NULL /* LONGINT meta=0 nullable=1 is_null=1 */
### @15=NULL /* SHORTINT meta=0 nullable=1 is_null=1 */
### @16=2048 /* LONGINT meta=0 nullable=1 is_null=0 */
### @17=719317 /* INT meta=0 nullable=1 is_null=0 */
### @18=517475 /* INT meta=0 nullable=1 is_null=0 */
### @19=0 /* SHORTINT meta=0 nullable=0 is_null=0 */
### @20=140000 /* INT meta=0 nullable=1 is_null=0 */
### @21=0 /* INT meta=0 nullable=1 is_null=0 */
### @22=1 /* TINYINT meta=0 nullable=0 is_null=0 */
### @23=0 /* TINYINT meta=0 nullable=0 is_null=0 */
### @24=0 /* TINYINT meta=0 nullable=0 is_null=0 */
### @25='16166407' /* VARSTRING(256) meta=256 nullable=1 is_null=0 */
### @26='次' /* VARSTRING(256) meta=256 nullable=1 is_null=0 */
### @27=0 /* LONGINT meta=0 nullable=1 is_null=0 */
### @28=0 /* INT meta=0 nullable=0 is_null=0 */
### @29=NULL /* INT meta=0 nullable=1 is_null=1 */
### @30=2 /* INT meta=0 nullable=1 is_null=0 */
### @31=1 /* SHORTINT meta=0 nullable=0 is_null=0 */
### @32=4 /* SHORTINT meta=0 nullable=0 is_null=0 */
### @33=140000 /* INT meta=0 nullable=0 is_null=0 */
### @34='[]' /* LONGBLOB/LONGTEXT meta=4 nullable=0 is_null=0 */
### @35=0 /* SHORTINT meta=0 nullable=1 is_null=0 */
### @36=1736843515937 /* LONGINT meta=0 nullable=1 is_null=0 */
### @37=1736843515937 /* LONGINT meta=0 nullable=1 is_null=0 */
### @38=0 /* SHORTINT meta=0 nullable=0 is_null=0 */
### @39=NULL /* TINYINT meta=0 nullable=1 is_null=1 */
### @40=0 /* INT meta=0 nullable=1 is_null=0 */

恢复

通过日志中的数据和表结构组装成insert语句,执行即可恢复删除的数据。

引用

前文Hexo Next主题添加友链从其他博客获取的样式有一些问题:

  • 只在网页全屏时友链卡片比例显示正常,调整分辨率后不同行的卡片比例会乱掉
  • 图片没有按比例显示,样式不一致

即没有自适应,这里使用Cursor优化下样式,并添加了图片自适应样式,按网页大小调整列数,最多显示6列,默认4列,并且文字仅显示一行,超出的显示省略号.

这是修改后的效果

修改

下载

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
// 随机排列
function shuffle(arr) {
let i = arr.length;
while (i) {
let j = Math.floor(Math.random() * i--);
[arr[j], arr[i]] = [arr[i], arr[j]];
}
}

// 渲染数据
// function renderlink(data) {
// var name, avatar, site, li = "";
// shuffle(data);
// for (var i = 0; i < data.length; i++) {
// name = data[i].name;
// avatar = data[i].avatar;
// site = data[i].site;
// li += '<div class="card">' + '<a href="' + site + '" target="_blank">' + '<div class="thumb" style="background: url( ' + avatar + ');">' + '</div>' + '</a>' + '<div class="card-header">' + '<div><a href="' + site + '" target="_blank">' + name + '</a></div>' + '</div>' + '</div>';
// }
// document.querySelector(".link-navigation").innerHTML = li;
// }
function renderlink(data) {
shuffle(data);
const linkContainer = document.querySelector(".link-navigation");
linkContainer.innerHTML = data.map(item => `
<div class="card">
<div class="thumb" style="background-image: url('${item.avatar}');"></div>
<div class="card-header">
<a href="${item.site}" target="_blank">${item.name}</a>
</div>
</div>
`).join('');
}

// 获取 json 文件
fetch('/links/linklist.json')
.then(response => response.json())
.then(res => renderlink(res));

下载

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
114
115
116
117
118
119
120
121

.link-navigation {
margin-top: 1rem;
display: grid;
grid-template-columns: repeat(4, 1fr);
/* 默认4列 */
gap: 16px;
max-width: 100%;
}

/* 在小屏幕上自适应为更少的列数 */
@media (max-width: 768px) {
.link-navigation {
grid-template-columns: repeat(2, 1fr);
/* 小屏幕显示2列 */
}
}

@media (min-width: 768px) and (max-width: 992px) {
.link-navigation {
grid-template-columns: repeat(3, 1fr);
/* 中等屏幕显示3列 */
}
}

/* 添加大屏幕配置 */
@media (min-width: 1920px) {
.link-navigation {
grid-template-columns: repeat(5, 1fr);
/* 2K屏幕显示5列 */
gap: 24px;
/* 增加列间距 */
}
}

@media (min-width: 3840px) {
.link-navigation {
grid-template-columns: repeat(6, 1fr);
/* 4K屏幕显示6列 */
gap: 32px;
/* 进一步增加列间距 */
}
}

.card {
font-size: 1rem;
padding: 0;
border-radius: 4px;
transition-duration: .15s;
margin-bottom: 1rem;
box-shadow: 0 2px 6px 0 rgba(0, 0, 0, .12);
background: #f5f5f5;
width: 100%;
/* 保持正方形 */
aspect-ratio: 1;
overflow: hidden;
display: flex;
flex-direction: column;
position: relative;
/* 添加相对定位 */
}

.card:hover {
transform: scale(1.1);
box-shadow: 0 2px 6px 0 rgba(0, 0, 0, .12), 0 0 6px 0 rgba(0, 0, 0, .04);
}

.card .thumb {
position: absolute;
/* 绝对定位 */
top: 0;
left: 0;
width: 100%;
height: calc(100% - 40px);
/* 减去标题栏高度 */
background-position: center !important;
background-repeat: no-repeat !important;
background-size: contain !important;
/* 改为 contain 确保图片完整显示 */
}

.posts-expand .post-body img {
margin: 0;
padding: 0;
border: 0;
}

.card .card-header {
position: absolute;
/* 绝对定位 */
bottom: 0;
left: 0;
width: 100%;
height: 40px;
/* 固定标题栏高度 */
padding: 8px;
background: rgba(255, 255, 255, 0.9);
display: flex;
align-items: center;
justify-content: center;
}

.card .card-header a {
font-style: normal;
color: #2bbc8a;
font-weight: 700;
text-decoration: none;
border: 0;
display: block;
width: 100%;
text-align: center;
white-space: nowrap;
overflow: hidden;
text-overflow: ellipsis;
transition: all 0.3s;
}

.card:hover .card-header a {
white-space: normal;
overflow: visible;
}

基础

HashSet 的底层实现说下?为什么内置 HashMap ?
说下它的数据结构,为什么 loadFactor 是 0.75 ?你说泊松分布,什么是泊松分布?为什么要高位参与与运算?
为什么它的 size 是 2 的 n 次方?为什么默认是 16 ?
讲下它的扩容机制。什么时候转红黑树,为什么要转红黑树?
为什么它是线程不安全的,它的哪些方法是线程不安全的?
为什么会造成死循环? 1.8 是如何解决这个问题的?它的线程安全的实现有什么?

ConcurrentHashMap 和 HashTable 有什么区别?说下它 1.7 和 1.8 的实现是什么?有什么区别?为什么要这么做?为什么说 ConcurrentHashMap 是线程安全的?它的 get 操作是有锁的吗?它是强一致性的吗?它为什么是弱一致性的? ConcurrentHashMap 1.7 和 1.8 是如何扩容的? sizeCtl 参数是干什么的,讲讲变换过程?为什么要用 volatile 修饰?说说它的功能?什么是 MESI 协议?

CPU 原语是什么?什么是可见性?
JMM 说说是什么?为什么要有 JMM ?
Happened-before 是什么?它和 synchronized 的区别是什么?
锁的升级与降级说下是什么?自旋锁是什么?偏向锁是什么? Mark-Word 说下?锁的粒度是什么?锁消除了解吗?锁会被合并吗?什么时候会发生?你刚才说了 CAS ,你能说下它是什么东西吗?为什么要引入 CAS ? ABA 问题是如何解决的? AQS 了解吗?它是如何实现的? CLH 又是什么? ReentrantLock 和 synchronized 区别是什么?为什么 ReetrantLock 能实现公平锁?默认构造器是公平锁吗?为什么不是?

Copy-on-Write 了解吗? Fork/Join 又是什么?什么是线程,什么是协程?你刚才说了管程?你能说下这几个到底是做什么的吗?线程池说下参数,四种内置的拒绝策略,以及它的执行流程。你用过吗?为什么要这么设置参数?
I/O 密集型应用和计算密集型应用如何设置其参数?你具体的业务线程池的参数是怎么设计的?为什么?测过吗?你定制化开发过吗?线程池预留了 3 个供子类扩展的方法你知道是哪三个吗?能做什么你知道吗?
ThreadLocal 是什么?它为什么会造成内存泄漏?你实际开发中用到过吗?
Spring 事务用这个干什么的?什么是 Spring 事务的 SavePoint ?你知道死锁吗?如何解决死锁?

sleep 和 wait 的区别是什么?

BIO 、NIO 、AIO 是什么?说下区别,以及如何使用?了解 Netty 吗?如何解决粘包问题? ChannelPipeline 又是什么? ByteBuf 知道吗?读写指针又是什么?为什么要用它,解决了 NIO 类库的 ByteBuffer 什么问题?它和 mina 的区别是什么?它的 Zero-Copy ?了解过 FastThreadLocal 吗?它为什么比 ThreadLocal 快?有看过其中源码吗? Netty 解决了 NIO 类库的什么问题?空轮询又是什么? RPC 又是什么?序列化和反序列化又是什么?几个核心抽象说下。是干什么的?讲讲 Netty 的线程模型。

虚拟机

你说你了解虚拟机,你知道虚拟机的运行时数据区吗?哪些是线程共享的,哪些是线程独有的?

你了解 JVM 调优吗?调优过吗?为什么要这么设置?垃圾回收算法有几种?为什么要分代收集?

Young 区说说它的分布结构,为什么 Eden 区 80%?为什么大对象直接进入老年代?控制的参数是什么?一个对象如果不是大对象,怎样才能进入老年代?控制的参数是什么?

什么时候会发生 OOM ?你遇到过吗?怎么解决的?为什么低版本的 JDK 要把永久代内存调大点?默认大小是多少你知道吗?什么是 Major GC ,什么是 Minor GC ?什么情况下会频繁 GC ?你查看过 GC 日志吗?什么时候回收对象?引用计数和可达性分析是什么?为什么 Java 使用后者? Python 使用前者?

什么是 GCRoot ?什么类型的对象可以作为 GCRoot ?什么时候对象不可达? Java 的四种引用说下,分别用在什么场景?你知道 JDK 源码哪里有用到 WeakReference 吗?什么是 STW ?什么是 Safepoint ?类加载的过程说下,什么时候优化,以及不同的阶段的主要优化是什么?解语法糖是什么时候?为什么在编译的时候解语法糖?什么是双亲委派模型?可以破坏吗?各个 ClassLoader 加载哪部分类的?你自定义过 ClassLoader 吗?你说你用过 Jstack 诊断 CPU 使用率飙升的情况,说下具体步骤? Arthas 用过吗? Class 文件格式说下,什么是魔数,Class 文件的魔数是什么? JMX 了解吗?生产上有碰到过虚拟机的问题吗?怎么解决的?

数据库

ACID 说下是什么,如何实现的?你说你优化过 SQL ,怎么优化的说下。

1
2
3
4
5
6
7
8
9
10
11
12
1. ACID 是什么?
ACID 是一组数据库管理系统(DBMS)的五个特性,用来保证数据库事务处理的正确性。
A:Atomicity(原子性)
C:Consistency(一致性)
I:Isolation(隔离性)
D:Durability(持久性)

2. 如何实现的?
ACID 的原子性:原子性是指一个事务是一个不可分割的工作单位,事务中包括的诸操作要么都做,要么都不做。
ACID 的一致性:一致性是指一个事务对数据库中数据的修改,在事务开始之前和事务结束之后,都保持一致的、完整的状态。
ACID 的隔离性:隔离性是指一个事务的执行不能被其他事务干扰,即一个事务内部的操作及使用的数据对并发事务是隔离的,并发执行的事务之间不能互相干扰。
ACID 的持久性:持久性是指一个事务一旦提交,它对数据库中数据的改变就是永久性的,其结果会保留在数据库中,直到数据库被永久删除。

like ‘%xx%’,like ‘%xx’,like ‘xx%’ 哪种情况会用到索引,为什么?

1
2
3
4
5
6
7
8
9
10
11
在MySQL 8.0中:

LIKE '%xx%': 一般不会使用索引。 这是因为通配符%位于字符串的开头和结尾。数据库引擎无法利用索引来快速查找匹配项,因为它需要扫描整个表或至少扫描索引中大部分的条目来进行匹配。 索引只能用于匹配字符串的尾部或头部,而不能用于中间的匹配。

LIKE '%xx': 可能使用索引 (前缀索引)。 如果xx的长度足够短,并且索引是前缀索引(前缀索引只索引字符串的一部分),那么MySQL 可能使用索引。 MySQL会检查索引的前缀是否与xx匹配。如果匹配,则可以使用索引来缩小搜索范围。但是,如果xx太长,超过了索引的前缀长度,则索引将无效,MySQL仍然需要全表扫描。

LIKE 'xx%': 会使用索引 (如果索引类型合适)。 这是因为通配符%位于字符串的结尾。MySQL可以利用索引来快速查找以xx开头的字符串。数据库引擎可以从索引的开头开始查找,直到找到不匹配的项,从而避免全表扫描。

总结:

MySQL能否使用索引取决于LIKE条件中通配符%的位置和索引类型。只有当%位于搜索字符串的末尾(LIKE 'xx%'),或者%位于开头且索引是前缀索引并且匹配部分足够短(LIKE '%xx'),MySQL才有可能有效地使用索引来优化查询性能。 如果%位于字符串的中间(LIKE '%xx%'),则索引将几乎完全无效。

说下 MySQL 执行流程。

WAL(Write-Ahead Logging) 知道吗?

redo log 和 undo log 是什么,它们作用说下。

你说你改过 buffer_pool_size 等参数,为什么要改它?它里面的数据结构说下是什么?为什么冷热 3:7 ? join_buffer 你说你也改了,为什么?什么是驱动表和被驱动表?如何优化?

你说你建了索引,什么是蔟集索引,什么是非蔟集索引?什么是回表?什么时候会索引失效?你的二级索引什么用得多?为什么优先使用普通索引,而不是唯一索引?

MySQL 会死锁吗?什么是间隙锁?它会导致什么问题?

MVCC 说下是什么? 4 种事务说下是什么?哪种或者哪几种事务隔离级别能避免幻读?能避免脏读?

你说你还开启了 binlog ,能说说是什么吗? binlog 有几种格式?你选的是哪个?为什么?

canal 用过吗?说说它的原理。

MySQL 主从模式如何开启?你是如何优化 SQL 的?

上亿级别的数据你是如何优化分页的?为什么不建议在 MySQL 中使用分区机制?几个主要的线程说下它们是什么?做什么的? MySQL 读写了解吗?如何实现的?能做到强一致性吗?为什么?为什么删了数据还是磁盘空间不变?

自增主键用完了会怎么样?如何解决这个问题?自增主键什么时候是不连续的?这样做的好处是什么?为什么推荐用自增主键? B+ Tree 又是什么?如何迁移数据库?为什么不建议使用外键?

在高版本的 MySQL 中 count(1) 和 count(*) 区别是什么?

order by 是如何工作的?分页机制又是什么?

ACL 和 RBAC 是什么? PBAC 和 ABAC 知道吗说下?

grant 之后一定要刷新吗?

视图用过吗?它的作用说下。视图和表的区别说下。

存储过程写过吗?存储函数和存储过程的区别说下。

为什么要分库分表?分库分表如何做到动态缩容/扩容?

NoSQL 用过吗? OceanBase 了解吗? HBase 了解吗? HBase 有哪些坑,你碰到过吗?什么是 RegionServer ?什么时候用 NoSQL ,它能取代 RDBMS 吗?

你说你用过 Elasticsearch ,能说下它的请求执行过程吗?它的总体架构说下,画一下。它的插件你用过吗?你们的分词策略是什么?倒排索引说下是什么。

并发

线程和进程说下区别?线程的几种状态说下。

Java 中的线程和操作系统的线程关系?动态内存分配和回收策略是什么?

什么是空闲列表和指针碰撞?具体用什么数据结构存的?什么时候用它们?空闲列表四种策略说下。

Page Cache 知道吗,说说它的作用。Redis 和 Kafka 中间件如何通过 Page Cache 来优化?哪些类型会导致内存泄漏?

TCP 和 HTTP 是什么?它们之间的关系说下。OSI 七层是哪七层?分别是干什么的?
TCP 和 UDP 区别是什么?什么时候会导致 TCP 抖动? TCP 是如何保证稳定的?我就要用 UDP ,如何使它和 TCP 一样能保证数据到达?

CPU 是如何执行任务的?你知道 numa 架构吗?哪些中间件可以通过这个来怎么优化?为什么绑核能优化?

什么是 Zero-Copy ?你用的中间件中有哪些用到了这个特性?内核态和用户态是什么?硬件你了解过吗?

什么是 x86 ?什么是 ARM ?你说精简指令集?它精简了什么? ARM 架构的 CPU 是什么样的?画一下。M1 芯片为什么这么快,有了解吗?

5G 有了解吗?有点题外话了,最后问你个问题,你说你是软件通信工程,通信学的什么?选修了什么?通信是学硬件吗?光纤为什么这么快? 8 根线和 4 根线区别?傅立叶变换说下是什么?数字信号模拟信号?你大学在班级定位?前几?

缓存

Redis 它的 5 种基础类型和 6 个数据结构说下。

HyperLogLog 、BitMap 、GEO 、Stream 有接触过吗?什么时候用这些特殊数据结构?跳表又是什么,画一下?为什么使用跳表?为什么不用红黑树?全局 Hash 表又是什么?

如何扩容的?什么是渐进式 rehash ? Redis 怎么做到的?

IO 多路复用是什么?多路是什么?复用了什么?

AOF 和 RDB 又是什么?为什么 Redis 没有实现 WAL 机制? AOF 持久化策略有哪三种?你们是怎么选的? AOF 什么时候重写?为什么重写?主从复制用到了哪种日志?

主从复制过程说下。主从复制什么时候增量,什么时候全量?第一次连接时,网络中断了怎么办?
Redis 主从是什么?主从从又是什么?为什么主从从可以减少主库压力?从库可以设置可写吗?从库可写会带来什么问题?主从什么时候会导致数据丢失?

Redis 十万并发能支撑住吗?如何支撑十万以上并发?
为什么操作大对象支持不了十万并发?
Redis Cluster 是什么? 你说到了 CRC16 ,你知道一致性哈希算法吗,能说下是什么吗?
你说虚拟节点,说下如何实现? Codis 了解吗?

你们的 Redis 集群方案是什么? Redis 是如何保证高可用的?哨兵机制了解吗?什么是主观下线什么是客观下线?选主的四个筛选条件优先级的条件依次递减分别是什么?打分又是什么?如何打分?缓存击穿、缓存雪崩、缓存穿透说下?如何解决?布隆过滤器又是什么?能手写个布隆过滤器吗?数据倾斜知道吗,如何解决?分布式锁了解过吗?讲讲分布式锁实现原理? Redisson 源码看过吗?它是如何实现的分布式锁? Lua 脚本保证原子性吗?

分布式锁需要注意哪四个问题?

Redis 事务说下。缓存污染知道是什么吗?如何淘汰数据的?分别是哪八种策略? Redis 对 lru 做了什么改变吗? lfu 又是什么? Redis 做了什么优化?

Redis 多线程是什么多线程?默认开启吗?你们生产中用了吗? Redis 6 还有什么新特性?自定义过 Redis 数据类型吗?自定义过 Redis 命令吗?如何解决数据库和缓存数据不一致问题?

Pika 知道吗? Tendis 和它的区别?如何实现一个 Key 千万并发?(这个有个群的群友的 Zoom 面试题)

中间件

消息中间件解决了哪几个问题?

简单介绍下你用的 Kafka 。从 Topic -> Record<Key,Value> -> Producer -> acks -> Interceptor -> Broker -> Page Cache -> Controller -> Coordinator -> Partition -> Replica -> Leader Replica -> Follower Replica -> ISR -> Unclean Leader Election -> Consumer -> Consumer Group -> Consumer Offset -> Consumer Group Offset -> Idempotence -> Transaction -> Rebalance -> High Watermark -> Log Deletion -> Leader Epoch -> LEO -> Zero Copy -> Consumer Heartbeat -> Zookeeper 到这结束。它和 RocketMQ 、RabbitMQ 有什么区别?什么时候消息会丢失? Producer 网络抖动后,它的消息在哪存着,内存还是磁盘还是哪里? Producer 和 Consumer 什么时候建立的 TCP 连接?为什么这么做? Consumer 为什么要采取 pull 的方式? Producer 为什么采用 push 的方式?为什么用 TCP 不用 HTTP ?高水位、LEO 是什么? Lead Epoch 知道吗?

幂等性是如何实现的?说下 Kafka 事务,Kafka 事务实现的事务隔离级别?

什么时候触发 Rebalance ?如何避免?

如何指定发送消息到指定 Partition ?消息交付可靠性保障承诺三个说下,以及 Kafka 是如何实现它们的?

哦,你说精准一次,怎么实现的?根据消息数以及消息大小,计算需要多少磁盘容量和带宽。

Kafka 的 JVM 参数调优说下。JMS 了解吗?

Spring

Spring Bean Scope 说下。Spring 的注入方式有几种,为什么推荐用构造器注入?@Resource 和 @Autowired 区别说下。什么是 IoC 和 AOP ? Spring 解决了什么?@Bean 和 @Component 区别说下。Spring Bean 的生命周期说下。Spring AOP 原理,各种 Advice 和 Advisor 说下。AOP 的两种代理方式是什么? AOP 一般作用说下。三级缓存解决循环依赖的过程说下。Spring 的事务传播行为说下。Spring 事务隔离级别说下。Spring 事务实现原理。Spring 用到了哪些设计模式,能分别讲讲它是如何实现的吗,具体是哪些类? BeanFactory 和 ApplicationContext 说下区别。说下 BeanFactory 和 FactoryBean 区别? BeanPostProcessor 和 BeanFactoryPostProcessor 区别是什么? Spring 事件知道吗? Spring 如何自定义 XML 解析?各种 Smart 开头的 Bean 的前置处理器,什么时候被调用,你知道吗? Spring Cache 是如何实现的? Spring Data JPA 呢? 注解扫描如何实现的,你能手写个吗?写过 Spring 的插件吗?如何实现的?代码开源了吗?

Spring MVC 执行流程说下。 @RestController 和 @Controller 区别说下。怎么取得 URL 中的 { } 里面的变量? Spring MVC 和 Struts2 比有什么优点? Spring MVC 怎么样设定重定向和转发的?说下 Spring MVC 的常用注解。如何解决 POST 请求中文乱码问题,GET 的又如何处理呢? Interceptor 和 Filter 区别? Spring MVC 的异常处理 ?怎样在方法里面得到 Request ,或者 Session ? Spring MVC 中函数的返回值是什么?怎么样把 ModelMap 里面的数据放入 Session 里面? Spring MVC 的控制器是不是单例模式,如果是,有什么问题,怎么解决? Spring MVC 的 RequestMapping 的方法是线程安全的吗?为什么?介绍下 WebApplicationContext 。跨域问题如何解决?如何解决全局异常? validation 有了解吗?用过吗? Json 处理如何实现的?哦,你刚才说了父子容器,能讲讲什么是父子容器吗? Spring MVC 国际化有了解过吗?怎么实现的

Spring Boot 是如何实现自动装配的?运行 Spring Boot 有几种方式? Spring Boot Starter 工作原理。Spring Boot 核心注解说下。 @Enable 类型注解是如何实现的?@Conditional 类型注解呢?自定义过吗?说下异步调用 @Async 。什么是 YAML ? Spring Boot Profiles 如何实现的? bootstrap.properties 和 application.properties 说下区别。Spring Boot 事件和 Spring 事件有什么关系? Spring Boot Actuator 了解过吗?说一下。Spring Batcher 用过吗,说下。Spring Boot 是如何实现内嵌 Servlet 容器的,在哪行代码启动的? Spring Boot 完美实现了模块化编程,你认同吗?

Spring Cloud Netflix 听说你了解。画一下 Spring Cloud Netflix 架构图。说说 Eureka 默认多少秒发送心跳?增量还是全量? CP 还是 AP ?如何防止脑裂的?二级缓存知道吗? Eureaka 的自我保护模式说下。ServiceInstance 和 DiscoryClient 知道吗?是干嘛的?分布式事务除了两段提交,还有什么实现方式?哦,你说 Saga ,Saga 你说下是什么? Ribbon 是什么说一下,它解决了什么问题? Feign 又是什么?它和 Ribbon 什么关系? Dubbo 和 Feign 区别? Dubbo 的 SPI 知道吗? Zuul 是什么?它和 Nginx 有什么区别?除了 Zuul 还有什么网关可选? Hystrix 是什么?它是如何实现的?熔断、降级和限流他们的区别说一下。Hystrix 信号量机制,隔离策略细粒度控制如何做的?了解过他们的源码实现吗?看过源码吗?你优化过吗?微服务十一点说一下分别是什么?分布式配置中心有哪些?你们用的 Apollo 还是 Spring Config 还是其他的?为什么?服务监控有了解吗?什么是幂等?如何实现接口幂等?如何实现分布式 Session ?有更好的方法吗?哦,你说了 JWT ,能详细说下吗?不同系统的间授权的 OAuth2 了解吗?

MyBatis

MyBatis 了解吗?一级缓存,二级缓存?# 和 $ 说下。如何实现的动态 SQL ? ORM 是什么?和 Hibernate 区别? MyBatis 工作原理? MyBatis 都有哪些 Executor 执行器?它们之间的区别是什么? MyBatis 中如何指定使用哪一种 Executor 执行器?模糊查询 like 语句该怎么写? MyBatis 是否支持延迟加载?如果支持,它的实现原理是什么? MyBatis 如何执行批量操作? SqlSessionFactoryBean 是什么?如何实现和 Spring 的整合的? Mapper 方法可以重载吗?为什么不可以? MyBatis 是如何将 SQL 执行结果封装为目标对象并返回的?都有哪些映射形式?哦,你说简单封装了 JDBC ,说下 JDBC 几个重要的类。为什么要预编译?有什么好处吗?

网关

Nginx 了解吗,说下其优缺点?怎么实现 Nginx 集群?

什么是反向代理?和正向代理区别是什么?

Tomcat 和 Nginx 区别?限流怎么做的,有哪三种?令牌桶和漏斗算法是什么,区别是什么?如何在其之上使用 Lua 脚本?

有几种负载均衡策略?你们生产上用的哪个?为什么?为什么 Nginx 性能这么高?有没有更高的? F5 又是什么? Nginx 是怎么处理请求的?
Nginx 目录有哪些? nginx.conf 配置过吗?有哪些属性模块?静态资源放哪?虚拟主机配置? location 说下。location 语法说下。

Tomcat 你也了解?什么是 Tomcat 的 Connector ? Service 、Connector 、Container 介绍下它们。详细说下它们是如何处理请求的,能画下它们的架构图吗?如何部署的?一定要放到 webapps 目录下吗?在哪配置?

为什么不用 Jetty ?区别是什么? Servlet 是线程安全的吗?为什么?怎样让它线程安全? Servlet 初始化过程? init 方法什么时候调用? Servlet 什么时候第一次初始化? JSP 知道吗?有几个内置对象?你说 JSP 是特殊的 Servlet ,你看过源码吗? JSP 如何热部署的? EL 表达式知道吗?如何实现的?(大四神州集团校招的时候被问到的)。

云原生

云原生了解吗?云原生十二要素说下。Cloud Foundry 平台你知道吗? HeroKu ? Kong ?

哦?你说是六边形架构?你说下什么是六边形架构?

整洁架构呢?它们之间的区别?分层架构了解吗? MVP 、MVC 架构说下。

负载均衡算法七种说下。如何实现一个秒杀系统。一定不会超卖吗?如何解决?

什么是 SOA ?什么是微服务?以及两者的区别。

什么是事件驱动架构?

CAP 和 BASE 说下是什么?最终一致性和人弱一致性什么关系?

画一下你们系统的整体架构图。QPS 和 TPS ?你们的 QPS 是多少知道吗?压测过吗?说下点击网页的请求过程。

哦,你说你是蓝绿部署,什么是蓝绿部署?什么是金丝雀发布?如何实现?

Docker 你也用?怎么构建 Docker 镜像? Docker 和虚拟机的区别? Docker 好处说下?

Kubernetes 你也知道,说下它的组成结构? etcd 是什么?为什么不用 Zookeeper ? pod 又是什么?你们生产上怎么用的?如何控制滚动更新过程?

微服务

你说你知道 DDD ?能简单说下吗?你们代码落地了吗?是如何拆分服务的?事件风暴又是什么?

你们有 Code Review 吗?具体规矩?

领域事件是什么?子域、通用域、核心域、支撑域、限界上下文、聚合、聚合根、实体、值对象又是什么?

你们有 EventBus 吗?如何使用的?

来源

上一篇我们介绍了MCP的架构:C/S架构,主要是客户端和服务端,下面我们学习下如何使用Claude提供的以及一些开源MCP服务端.

主要在vscode插件中使用,这里以Continue/Cline为例,以上的服务端区别于传统互联网服务端,需要安装在本地,目前大部分通过npx或python pip使用,暂不支持远程服务端

Continue

配置

1
2
3
4
5
6
7
8
9
10
11
12
13
14
// ~/.continue/config.json
{
"experimental": {
"modelContextProtocolServers": [
{
"transport": {
"type": "stdio",
"command": "uvx",
"args": ["mcp-server-sqlite", "--db-path", "/Users/NAME/test.db"]
}
}
]
}
}

Cline

使用效果如下,这里调用官方的everything服务端中的printEnv工具输出环境变量

使用效果

配置

配置

1
2
3
4
5
6
7
8
9
10
11
{
"mcpServers": {
"everything": {
"command": "npx",
"args": [
"-y",
"@modelcontextprotocol/server-everything"
]
}
}
}

参考

这段 2009 年的旧视频最近在 Twitter 上疯传。它旨在让观众直观地了解 CPU 和 GPU 之间的区别。

你可以在这里观看,时长 90 秒:

视频

这个想法是,CPU 和 GPU 在绘画决斗中正面交锋。
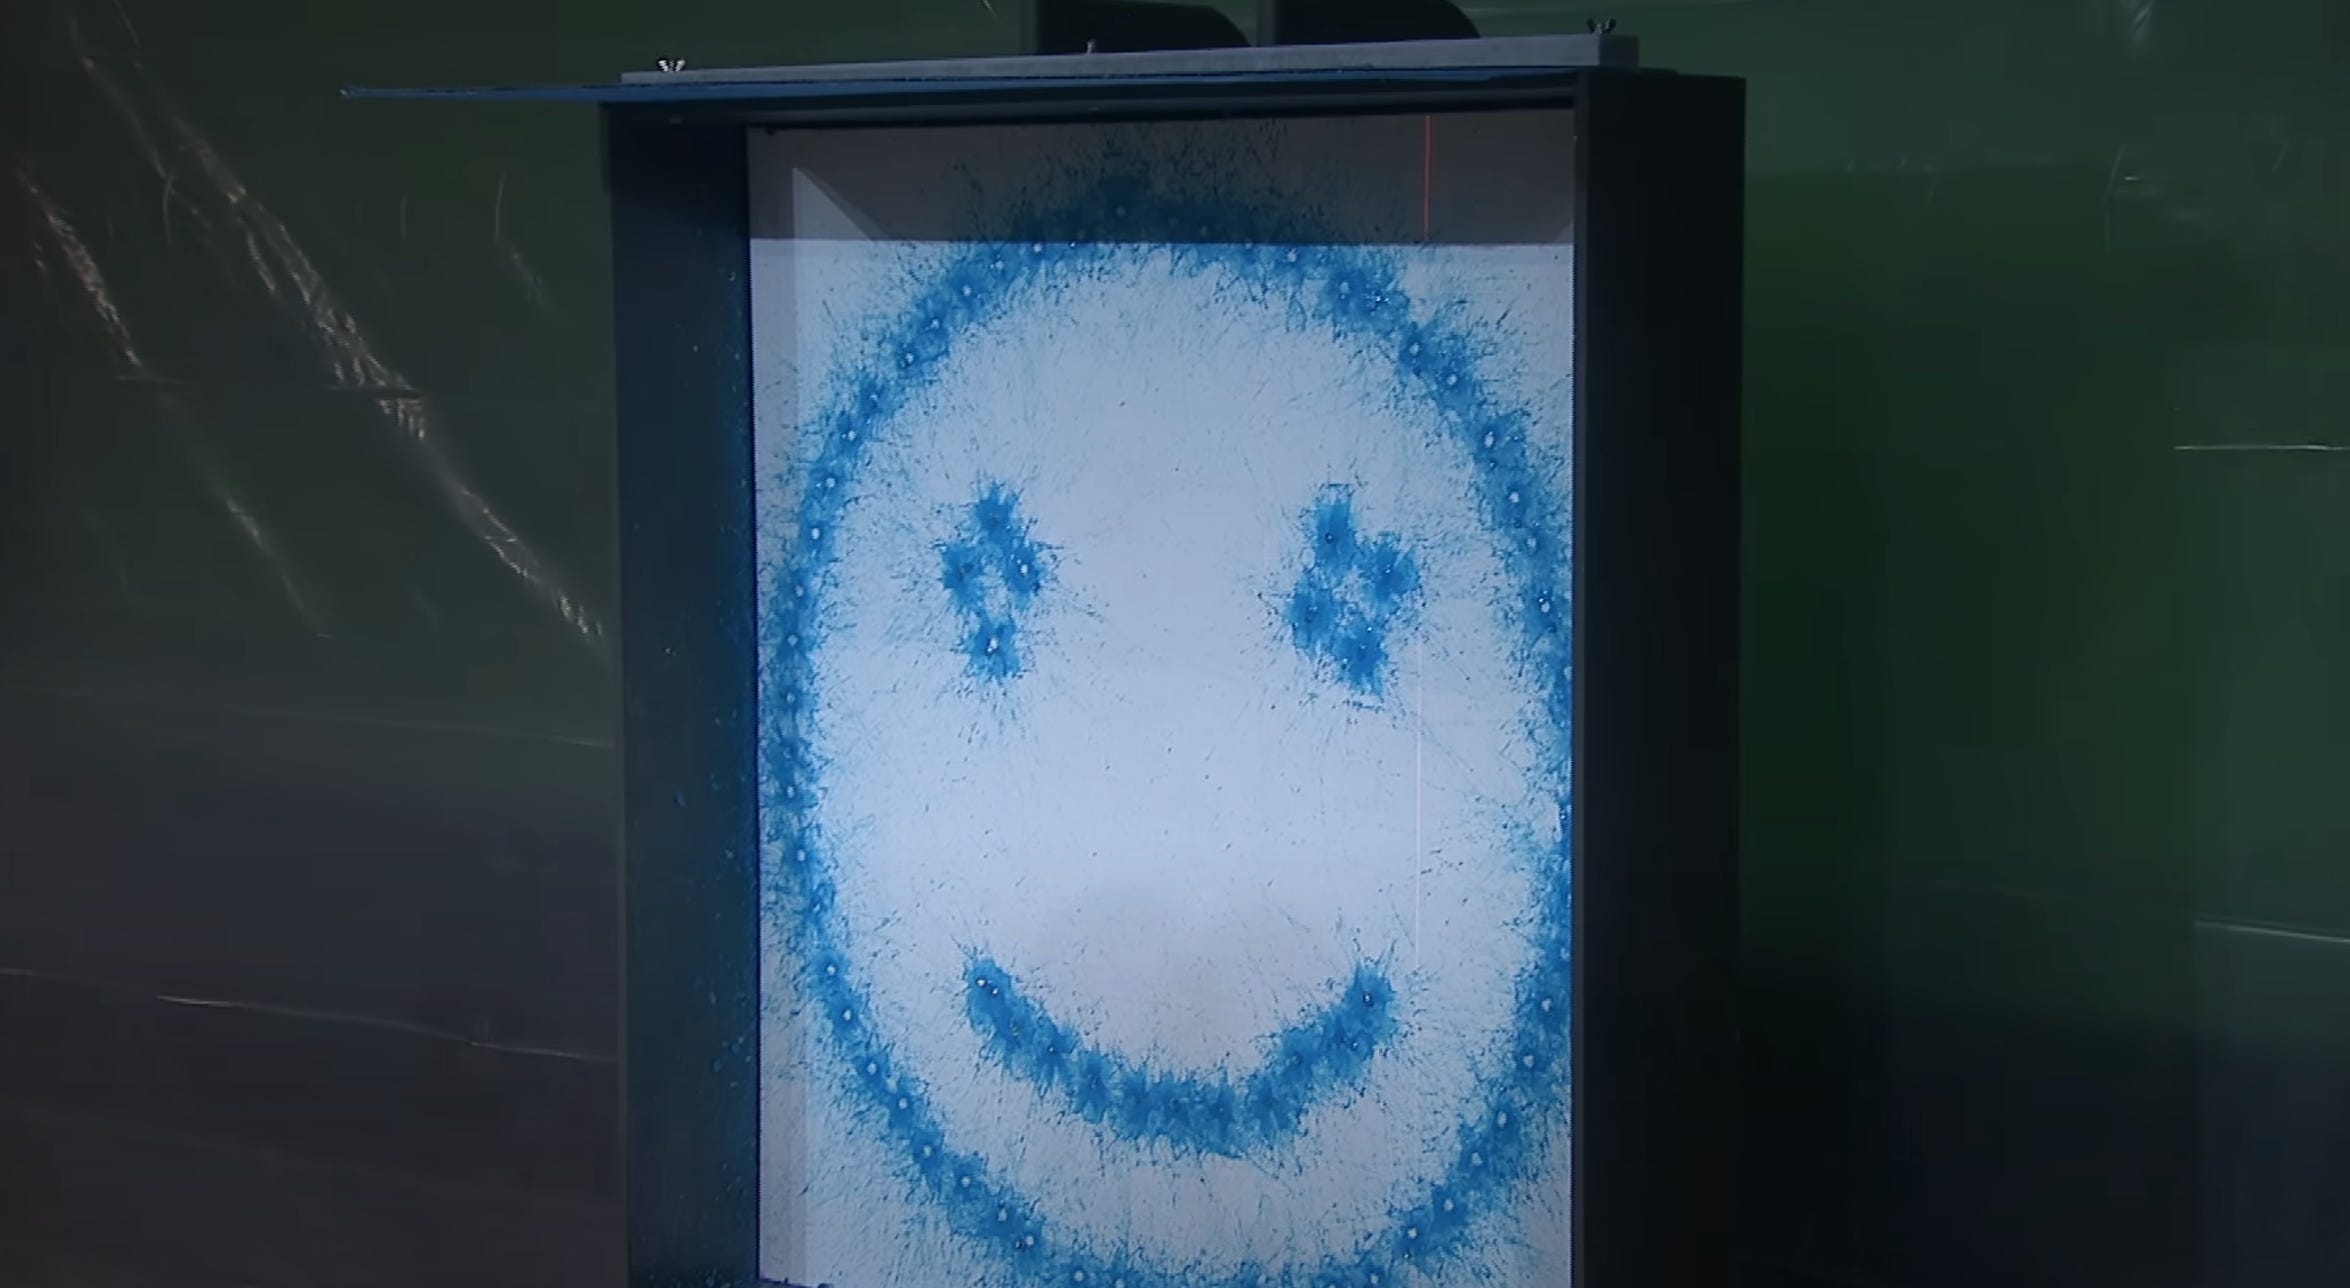
CPU 花了整整 30 秒才画出一个非常基本的笑脸:

图像 15

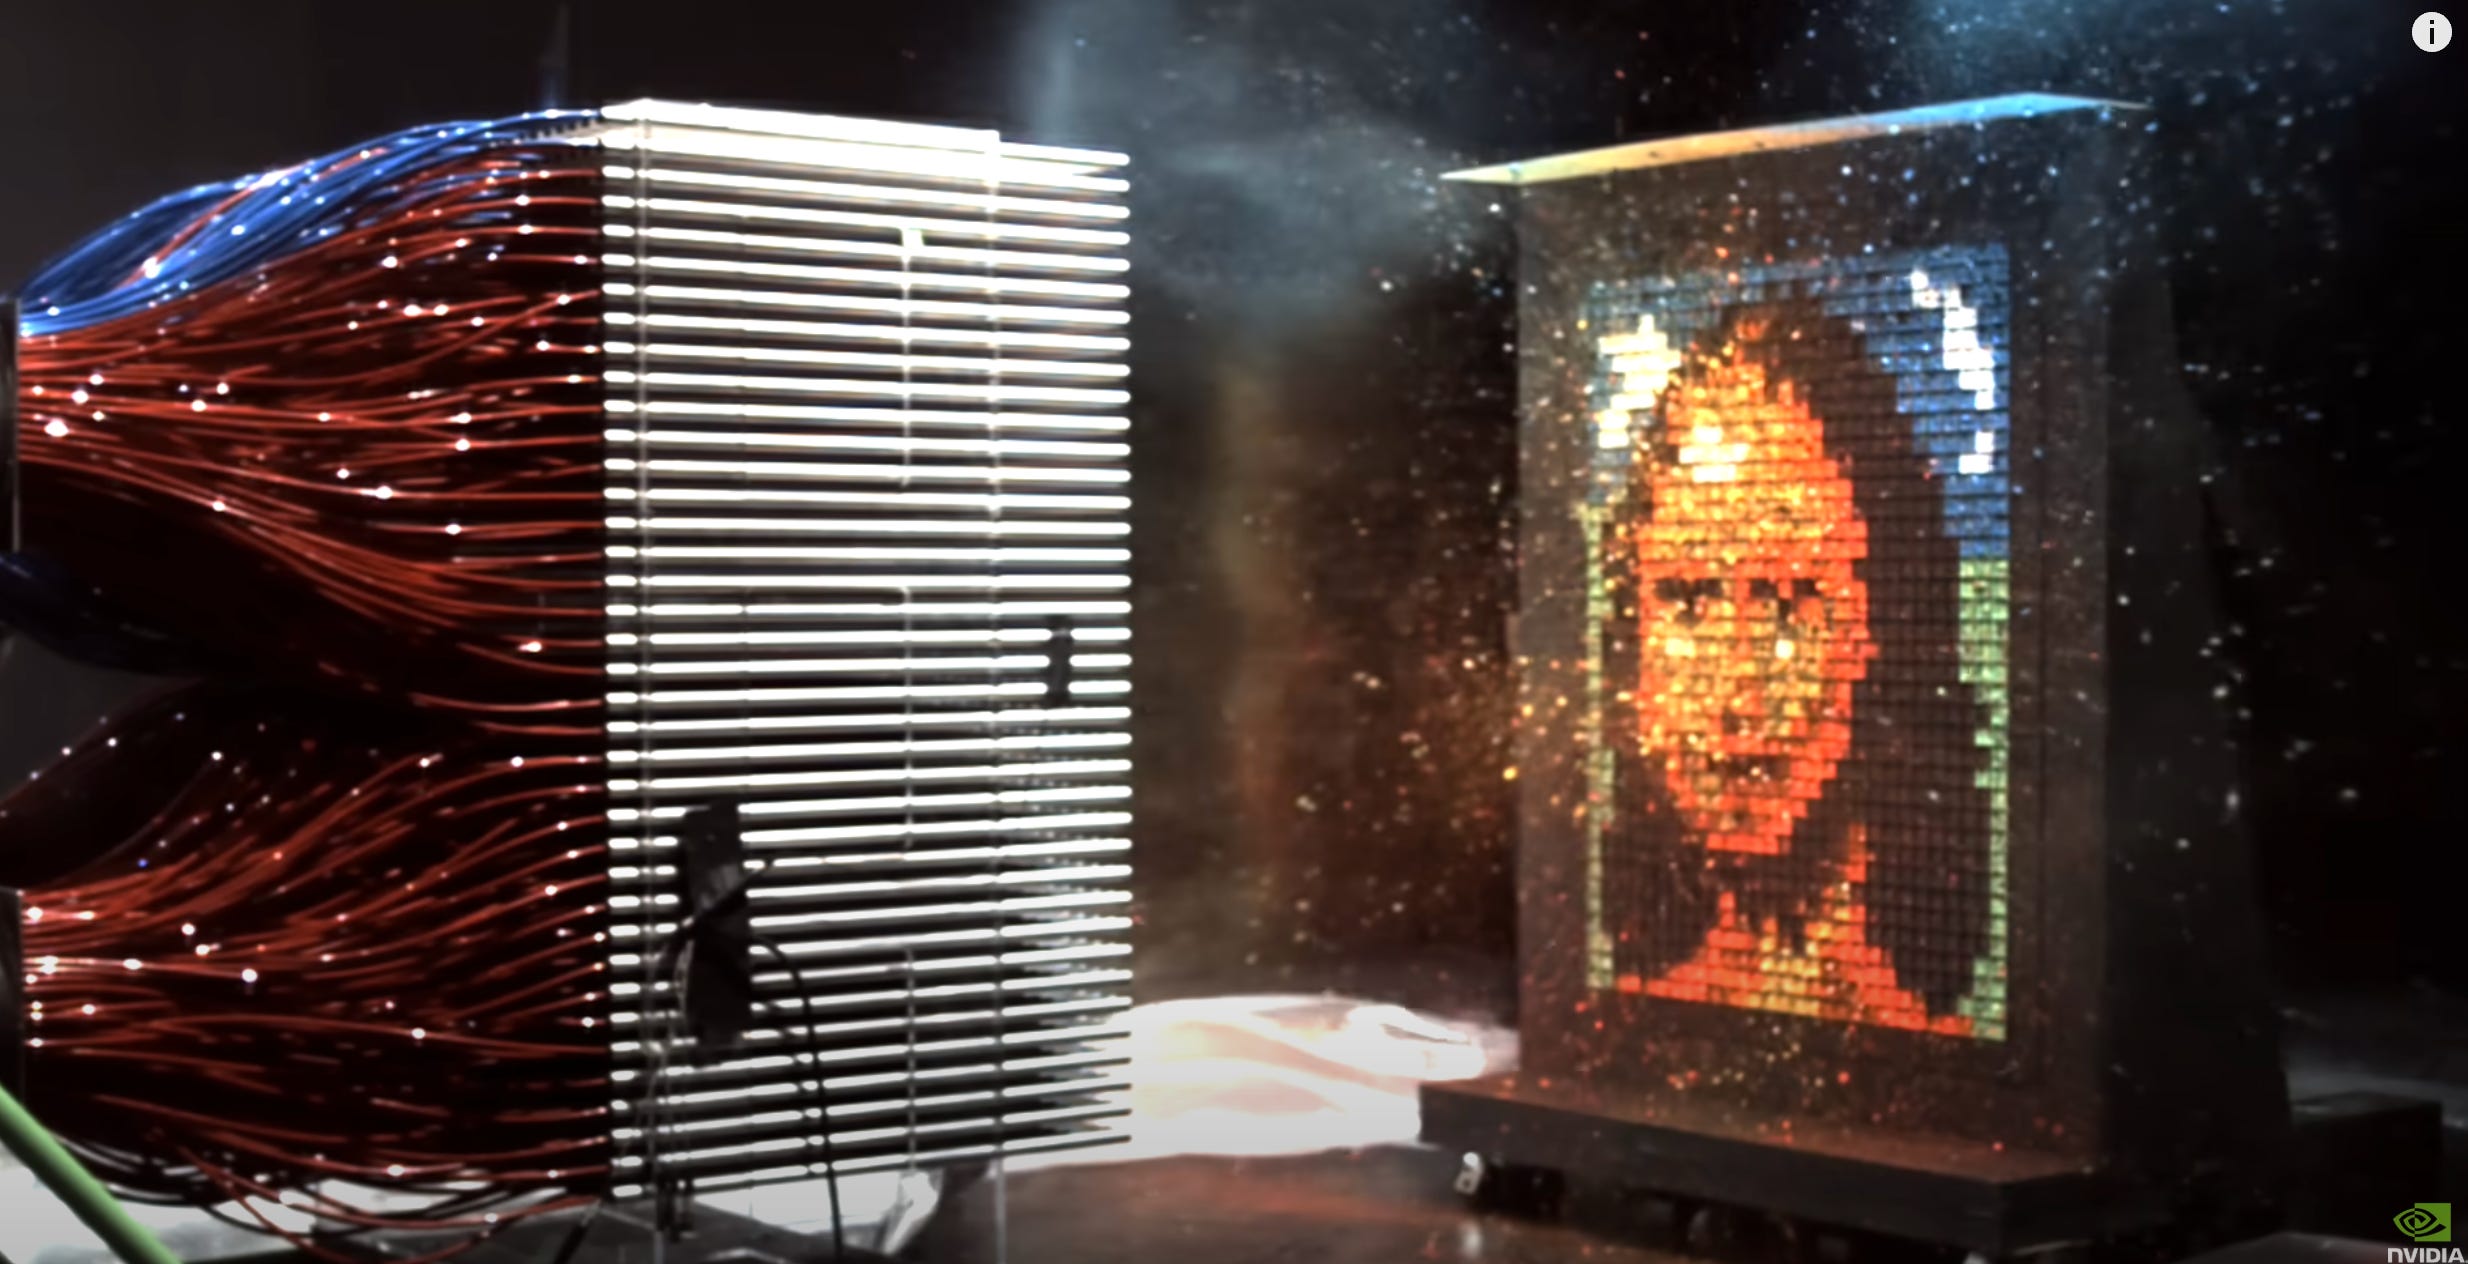
然后 GPU 瞬间画出了蒙娜丽莎:

图像 16

从这段视频中可以得出一个结论:CPU 速度慢,而 GPU 速度快。虽然这是事实,但其中有很多视频没有给出的细微差别。

当我们说 GPU 的性能比 CPU 高得多时,我们指的是一个名为 TFLOPS 的指标,它本质上衡量的是处理器在一秒内可以执行多少万亿次的数学运算。例如,Nvidia A100 GPU 可以执行 9.7 TFLOPS(每秒 9.7 万亿次运算),而最近的 Intel 24 核处理器可以执行 0.33 TFLOPS。这意味着一个中等水平的 GPU 至少比最强大的 CPU 快 30 倍。

但是我的 MacBook 中的芯片(Apple M3 芯片)包含 CPU 和 GPU。为什么?我们不能直接抛弃这些速度慢得可怕的 CPU 吗?

让我们定义两种类型的程序:顺序程序 和 _并行程序_。

顺序程序 是指所有指令必须一个接一个运行的程序。以下是一个示例。

1
2
3
4
5
6
7
8
9
def sequential_calculation():
a = 0
b = 1

for _ in range(100):

a, b = b, a + b

return b

在这里,我们连续 100 次使用前两个数字计算下一个数字。这个程序的重要特性是每个步骤都依赖于它之前的两个步骤。如果你要手动进行此计算,你不能告诉朋友,“你计算第 51 步到第 100 步,而我从第 1 步开始”,因为他们需要第 49 步和第 50 步的结果才能开始计算第 51 步。每个步骤都需要知道序列中前面的两个数字。

并行程序 是指可以同时执行多个指令的程序,因为它们不依赖于彼此的结果。以下是一个示例:

1
2
3
4
5
6
7
8
def parallel_multiply():
numbers = [1, 2, 3, 4, 5, 6, 7, 8, 9, 10]
results = []

for n in numbers:
results.append(n * 2)

return results

在这种情况下,我们进行十次完全独立的乘法运算。重要的是顺序无关紧要。如果你想和朋友分担工作,你可以说,“你乘以奇数,而我乘以偶数。”你可以单独且同时工作并获得准确的结果。

实际上,这种划分是一种错误的二分法。大多数大型实际应用程序都包含顺序代码和并行代码的混合。事实上,每个程序都会有一部分指令是_可并行化的_。

例如,假设我们有一个程序运行 20 次计算。前 10 个是必须按顺序计算的斐波那契数,但后面的 10 个计算可以并行运行。我们会说这个程序是“50% 可并行化的”,因为一半的指令可以独立完成。为了说明这一点:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
def half_parallelizeable():
# Part 1: Sequential Fibonacci calculation
a, b = 0, 1
fibonacci_list = [a, b]
for _ in range(8): # Calculate 8 more numbers
a, b = b, a + b
fibonacci_list.append(b)

# Part 2: Each step is independent
parallel_results = []
for n in fibonacci_list:
parallel_results.append(n * 2)

return fibonacci_list, parallel_results

前半部分必须是顺序的 - 每个斐波那契数都依赖于它之前的两个数。但是后半部分可以获取完整的列表并独立地将每个数字加倍。

你不能在没有先计算出第 6 个和第 7 个数字的情况下计算出第 8 个斐波那契数,但是一旦你有了完整的序列,你就可以将加倍操作分配给尽可能多的可用工作者。

总的来说,CPU 更适合_顺序程序_,而 GPU 更适合_并行程序_。这是因为 CPU 和 GPU 的基本设计差异。

CPU 具有少量的大型核心(Apple 的 M3 具有 8 核 CPU),而 GPU 具有许多小型核心(Nvidia 的 H100 GPU 具有数千个核心)。

这就是为什么 GPU 非常适合运行高度并行的程序 - 它们有数千个简单的核心,可以同时对不同的数据片段执行相同的操作。

渲染视频游戏图形是一个需要许多简单重复计算的应用程序。想象一下你的视频游戏屏幕是一个巨大的像素矩阵。当你突然将你的角色向右转时,所有这些像素都需要重新计算为新的颜色值。幸运的是,屏幕顶部的像素的计算与屏幕底部的像素的计算是独立的。因此,计算可以分布在 GPU 的数千个核心中。这就是为什么 GPU 对于游戏如此重要。

在矩阵乘以 10,000 个独立数字等高度并行任务中,CPU 比 GPU 慢得多。然而,它们擅长复杂的顺序处理和复杂的决策。

将 CPU 核心想象成一家繁忙餐厅厨房里的主厨。这位厨师可以:

  • 当一位 VIP 客人带着特殊的饮食要求到达时,立即调整他们的烹饪计划
  • 在准备精美的酱汁和检查烤蔬菜之间无缝切换
  • 通过重新组织整个厨房的工作流程来处理意外情况,例如停电
  • 协调多道菜肴,以便它们在恰当的时间热腾腾地新鲜送达
  • 在处理数十个不同完成状态的订单时保持食品质量

相比之下,GPU 核心就像一百个擅长重复性任务的厨师 - 他们可以在两秒钟内切一个洋葱,但他们不能有效地管理整个厨房。如果你要求 GPU 处理晚餐服务不断变化的需求,它会很吃力。

这就是为什么 CPU 对于运行计算机的操作系统至关重要。现代计算机面临着不断发生的不可预测事件:应用程序启动和停止、网络连接断开、文件被访问以及用户在屏幕上随机点击。CPU 擅长在保持系统响应能力的同时处理所有这些任务。它可以立即从帮助 Chrome 渲染网页切换到处理 Zoom 视频通话,再到处理新的 USB 设备连接 - 所有这些都同时跟踪系统资源并确保每个应用程序都获得公平的关注。

因此,虽然 GPU 擅长并行处理,但 CPU 仍然因其处理复杂逻辑和适应变化条件的独特能力而至关重要。像 Apple 的 M3 这样的现代芯片两者兼具:结合了 CPU 的灵活性和 GPU 的计算能力。

事实上,更准确的绘画视频版本会显示 CPU 管理图像下载和内存分配,然后再用 GPU 快速渲染像素。

原文

模型上下文协议简介

MCP(model context protocol)是一个开放协议,它标准化了应用程序如何为大型语言模型 (LLM) 提供上下文。
可以将MCP比作AI应用程序的USB-C端口。正如USB-C提供了一种标准化的方式来将您的设备连接到各种外围设备和配件一样,MCP提供了一种标准化的方式来将AI模型连接到不同的数据源和工具。

为什么选择MCP?

MCP帮助您在LLM之上构建代理和复杂的流程。LLM经常需要与数据和工具集成,而MCP提供:

  • 不断增长的预构建集成工具,您的LLM可以直接接入
  • 在LLM提供商和供应商之间切换的灵活性
  • 在基础设施中保护您的数据的最佳实践

架构

MCP架构

MCP的核心遵循客户端-服务端架构,其中主机应用程序可以连接到多个服务端:

  • MCP主机: 像Claude Desktop、IDE或希望通过MCP访问数据的AI工具之类的程序
  • MCP客户端: 与服务器保持1:1连接的协议客户端
  • MCP服务端: 每个服务端都通过标准化的模型上下文协议公开特定功能的轻量级程序
  • 本地数据源: 您的计算机的文件、数据库和MCP服务器可以安全访问的服务
  • 远程服务: 通过互联网(例如,通过API)提供的外部系统,MCP服务器可以连接到这些系统

需要注意的是,这里提到的服务端和传统后端服务端有些许差异,大部分实际需要运行在MCP主机或主机能访问的网络内,参考文档的章节:Using an MCP Client,单独运行MCP服务端并不是很有用,应该将其配置到MCP客户端中。

这是Claude Desktop(MCP的客户端之一)配置:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
{
"mcpServers": {
"memory": {
"command": "npx",
"args": ["-y", "@modelcontextprotocol/server-memory"]
},
"filesystem": {
"command": "npx",
"args": ["-y", "@modelcontextprotocol/server-filesystem", "/path/to/allowed/files"]
},
"git": {
"command": "uvx",
"args": ["mcp-server-git", "--repository", "path/to/git/repo"]
},
"github": {
"command": "npx",
"args": ["-y", "@modelcontextprotocol/server-github"],
"env": {
"GITHUB_PERSONAL_ACCESS_TOKEN": "<YOUR_TOKEN>"
}
},
"postgres": {
"command": "npx",
"args": ["-y", "@modelcontextprotocol/server-postgres", "postgresql://localhost/mydb"]
}
}
}

文档

通义万相视频模型,再度迎来史诗级升级!处理复杂运动、还原真实物理规律等方面令人惊叹,甚至业界首创了汉字视频生成。现在,通义万相直接以84.70%总分击败了一众顶尖模型,登顶VBench榜首。

Sora、Veo 2接连发布之后,AI视频生成的战场又热闹了起来。

就在昨天,通义万相视频生成模型迎来了重磅升级!

他们一口气推出了两个版本:注重高效的2.1极速版、追求卓越表现的2.1专业版。
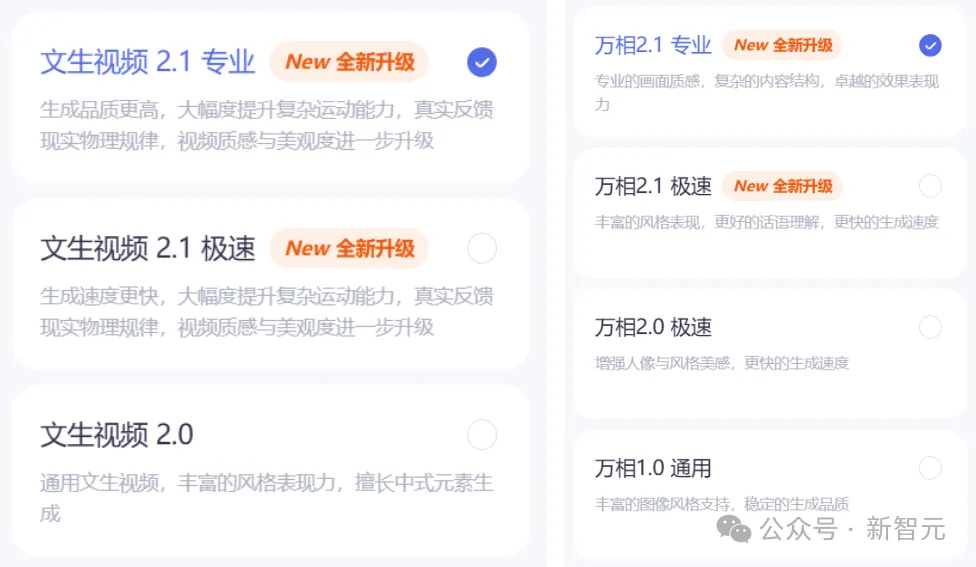
Image 4: 通义万相首创生成汉字视频,全面进化称霸VBench!AI视频GPT-3时刻来临

刚一上线,就异常火爆,等待时间甚至一度达到了1小时

此次,全面升级的模型不仅在架构上取得创新,更是以84.70%总分登顶权威评测榜单VBench榜首。

通义万相2.1的性能一举超越了Gen-3、CausVid等全球顶尖模型。

Image 5: 通义万相首创生成汉字视频,全面进化称霸VBench!AI视频GPT-3时刻来临

在实用性方面,通义万相2.1也得到了显著的提升,尤其是在处理复杂运动、还原真实物理规律、提升影视质感、优化指令遵循等方面。

以下都是我们实测出的Demos,就说够不够拍电影大片吧!
Image 6: 通义万相首创生成汉字视频,全面进化称霸VBench!AI视频GPT-3时刻来临

Image 7: 通义万相首创生成汉字视频,全面进化称霸VBench!AI视频GPT-3时刻来临

Image 8: 通义万相首创生成汉字视频,全面进化称霸VBench!AI视频GPT-3时刻来临

更令人惊叹的是,它还在业界首次实现了中文文字视频生成,让AI视频文字创作再无门槛。
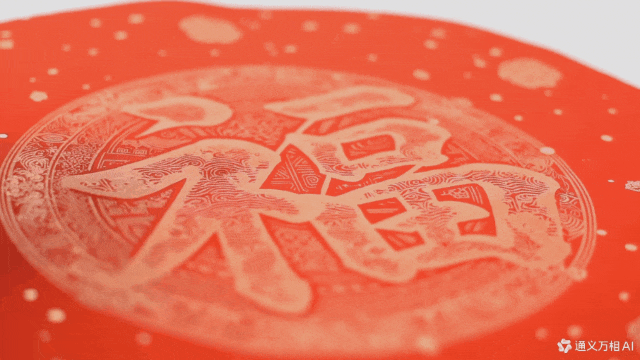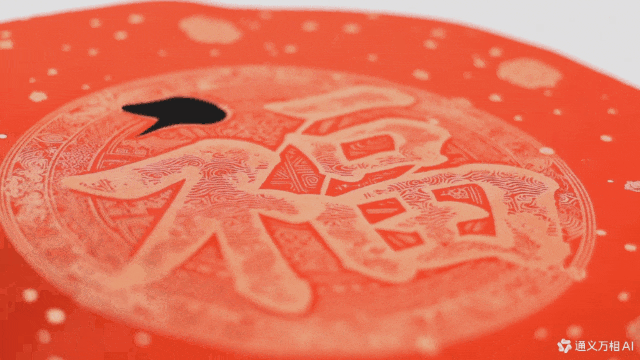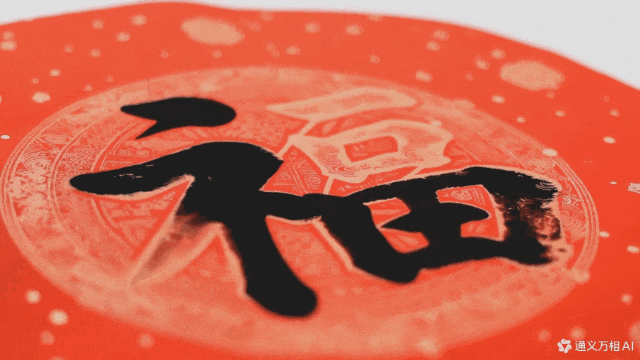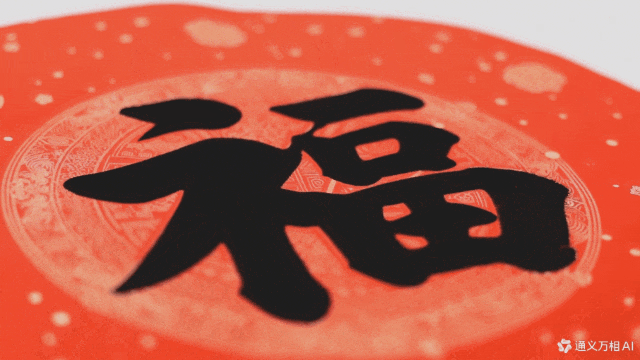
Image 9: 通义万相首创生成汉字视频,全面进化称霸VBench!AI视频GPT-3时刻来临

以红色新年宣纸为背景,出现一滴水墨,晕染墨汁缓缓晕染开来。文字的笔画边缘模糊且自然,随着晕染的进行,水墨在纸上呈现「福」字,墨色从深到浅过渡,呈现出独特的东方韵味。背景高级简洁,杂志摄影感。

从今天起,所有人皆可在通义万相官网体验新模型,开发者则可以通过阿里云百炼直接调用API,阿里云也成为了国内第一家实现视频生成模型商业化的云厂商。

那么,通义万相2.1究竟给我们带来了哪些惊喜?

我们经过一番实测后,总结出了5大要点。

1. 首创中文文字生成

通常来说,文字生成是AI视频模型进化的一大痛点。

我们已经看到Sora、Gen-3等模型,已经能够生成很好的英文字母效果,不过截至目前,从未有一个模型能攻克汉字的生成难题。
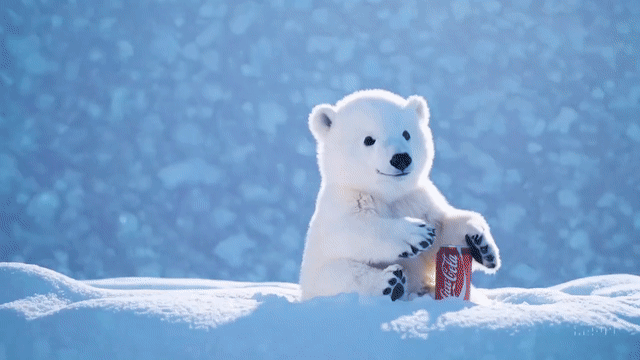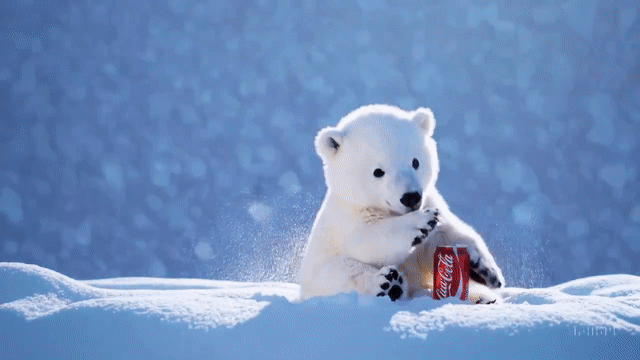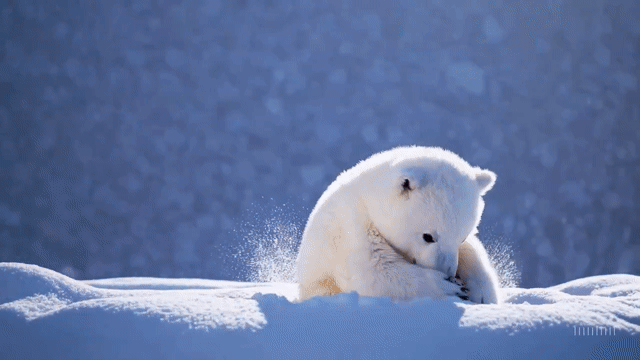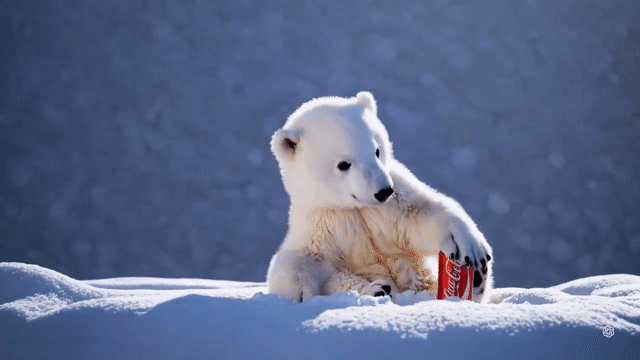
Image 10: 通义万相首创生成汉字视频,全面进化称霸VBench!AI视频GPT-3时刻来临

为什么之前的AI视频生成工具,都在「逃避」中文文字生成这个难题?

这是因为难点在于,中文文字的字体结构比英文更复杂,而且需要考虑笔画的层次感。在布局方面,中文字体更讲究,做成动态效果时对美感要求更高。

而阿里通义万相,便是首个中文文字视频生成的模型。从此,AI视频生成迈入「中文时代」!

这一切,只需要你动动手指,输入简单的文字提示就够了。
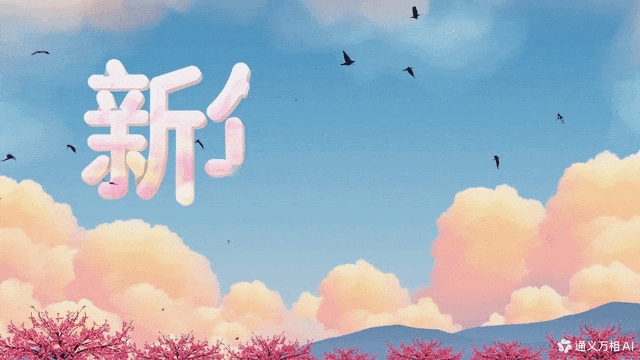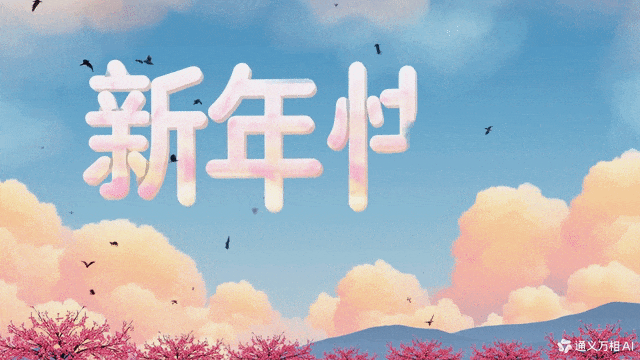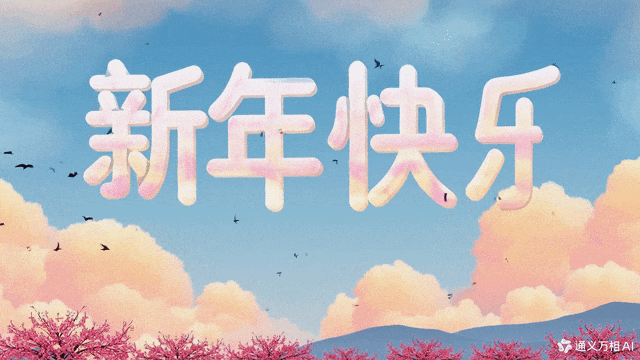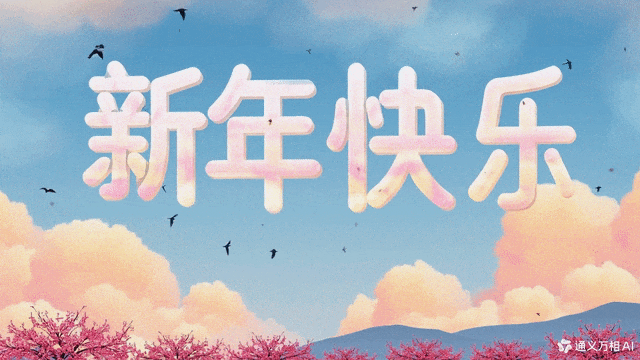
Image 11: 通义万相首创生成汉字视频,全面进化称霸VBench!AI视频GPT-3时刻来临

天空中飘着云朵,云朵呈现「新年快乐」的字样,微风吹过,云朵随着风轻轻飘动。
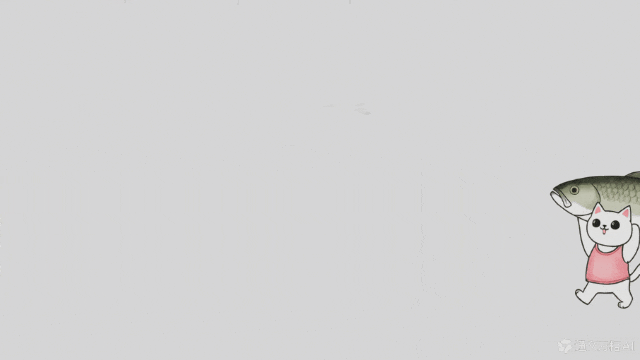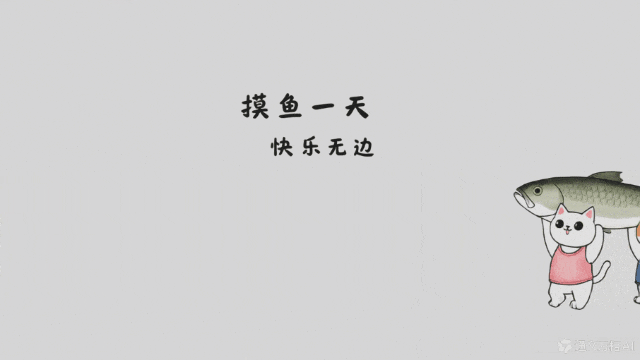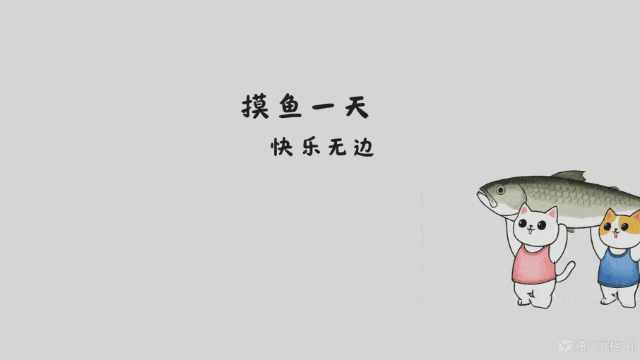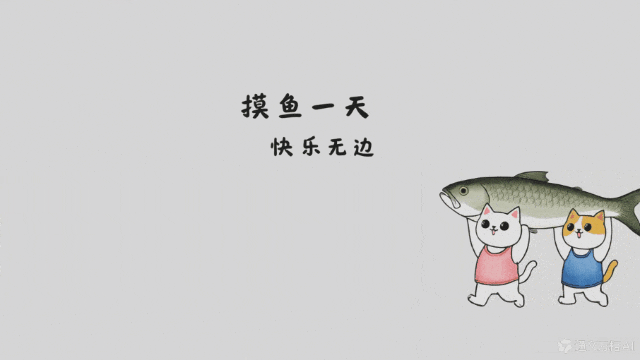
Image 12: 通义万相首创生成汉字视频,全面进化称霸VBench!AI视频GPT-3时刻来临

水彩透叠插画风格,两只不同颜色的可爱小猫咪手举着一条超大的鱼,从右边走到左边。它们分别穿着粉色和蓝色的小背心,眼睛圆圆的,表情呆萌。充满童趣,笔触淡雅温馨,简笔画风格。纯白背景上逐渐显示出来几个字体,写着:「摸鱼一天 快乐无边」。

一只柯基坐在桌前冥想,背后一个「静」字非常应景。
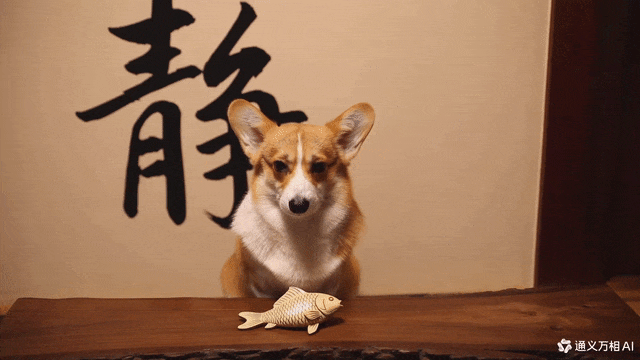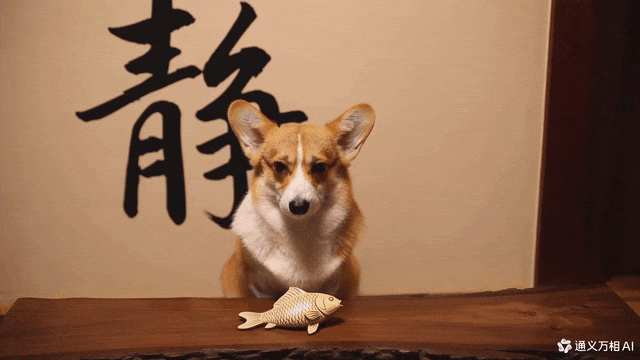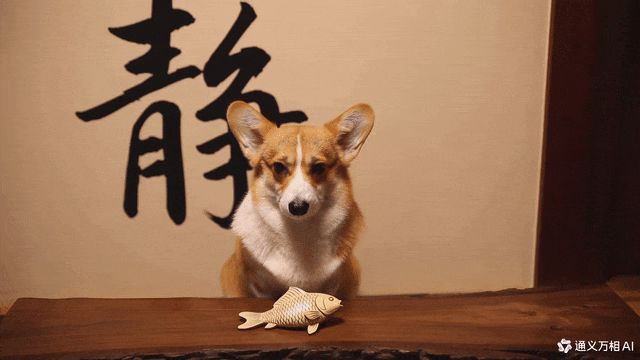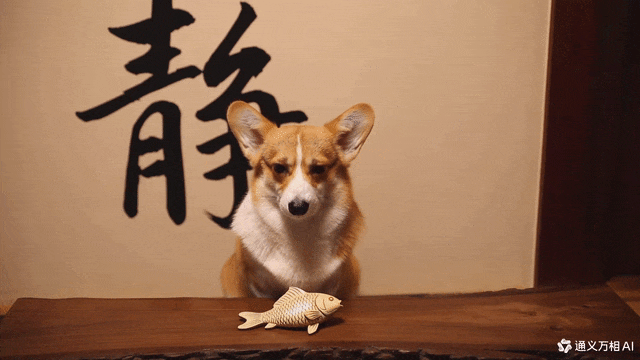
Image 13: 通义万相首创生成汉字视频,全面进化称霸VBench!AI视频GPT-3时刻来临

一只柯基面前摆放着一只小巧的木鱼,仿佛在进行冥想仪式,背景出现字样「静」。

2. 更稳定的复杂运动生成

对于大多数AI视频模型来说,无法逃脱「体操」魔咒。有人称,这是AI视频最新的「图灵测试」。

你会经常看到,AI体操视频生成中,扭曲的肢体、不协调的动作满屏皆是。
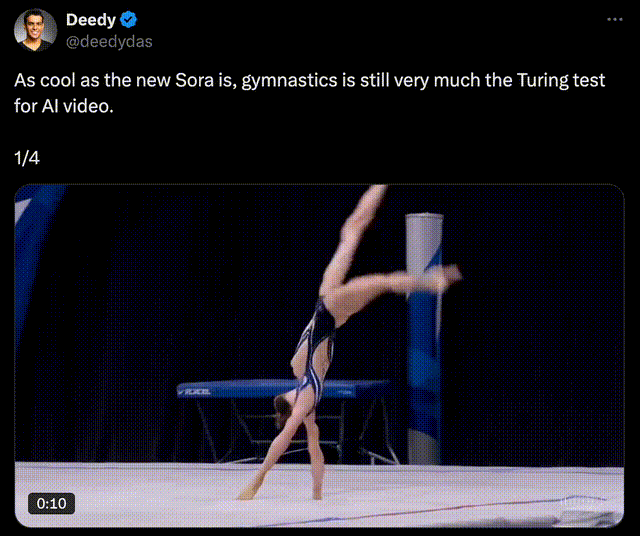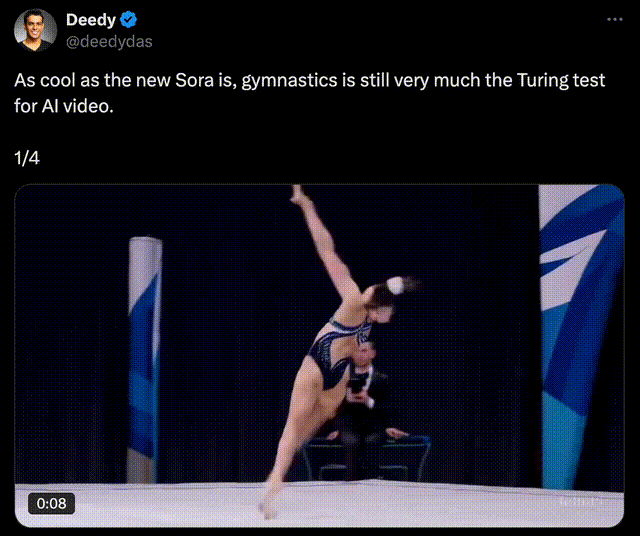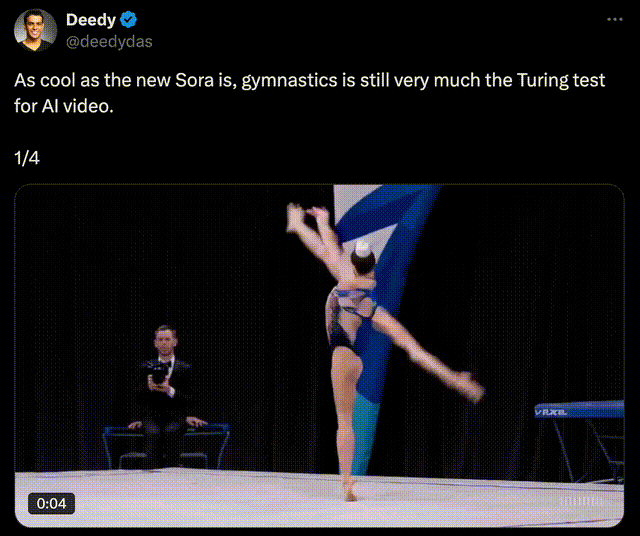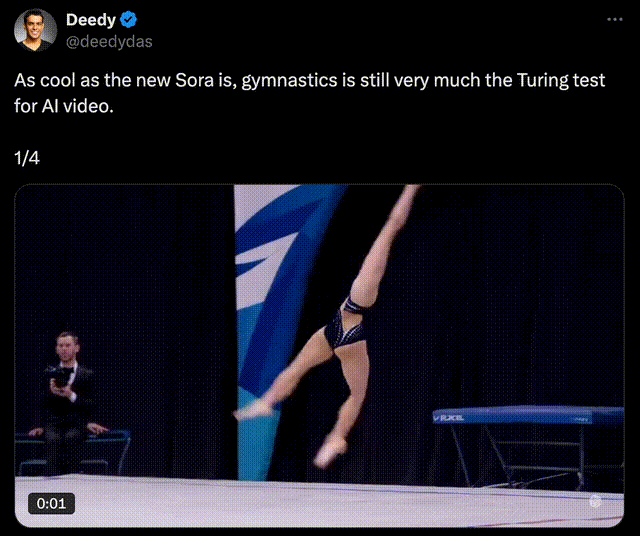
Image 14: 通义万相首创生成汉字视频,全面进化称霸VBench!AI视频GPT-3时刻来临

这仅是复杂肢体运动的一种,因为涉及到精细细节和高水平动作协调,成为了AI视频生成的一项重要评判标准。

生成一个人物复杂运动,对于AI来说就像是在解一道物理难题——

它不仅要做到身体各个部位精准配合,让四肢保持协调,还要考虑重力、人体运动特点、平衡感等各种细节。

在最新升级中,通义万相在多种场景下展示了惊人的「运动天赋」。

滑冰、游泳、跳水这些极易出错的名场面,万相2.1也通通Hold住,没有出现任何诡异的肢体动作,和不符合物理规律的场景。
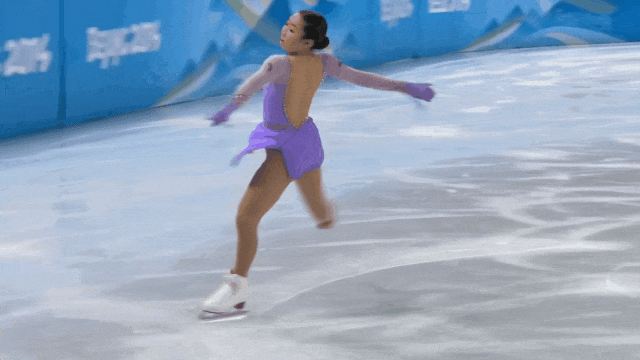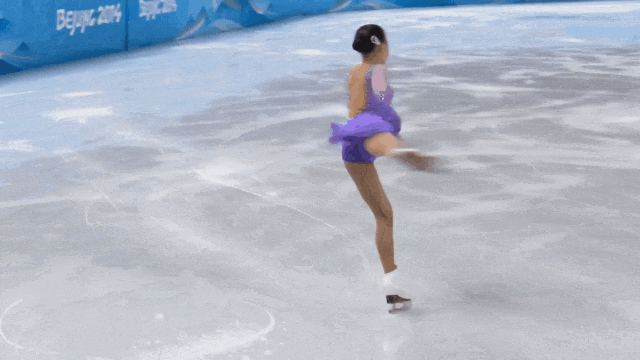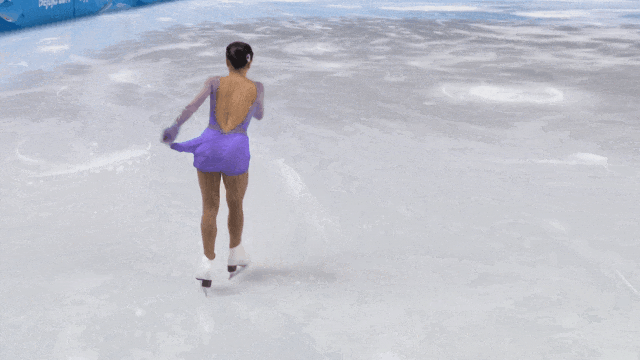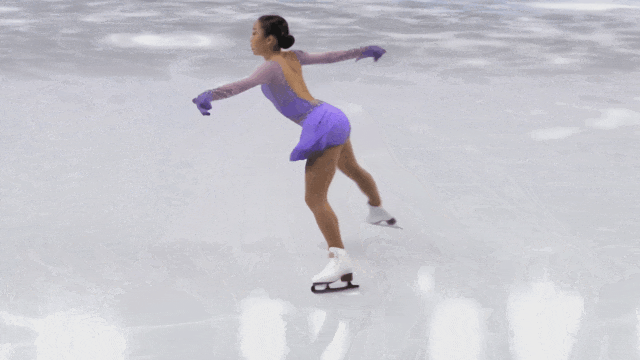
Image 15: 通义万相首创生成汉字视频,全面进化称霸VBench!AI视频GPT-3时刻来临

平拍一位女性花样滑冰运动员在冰场上进行表演的全景。她穿着紫色的滑冰服,脚踩白色的滑冰鞋,正在进行一个旋转动作。她的手臂张开,身体向后倾斜,展现了她的技巧和优雅。
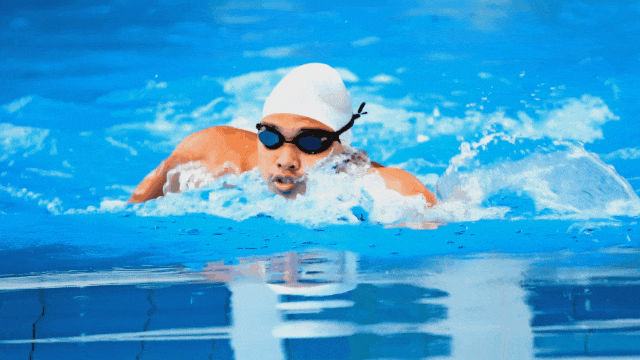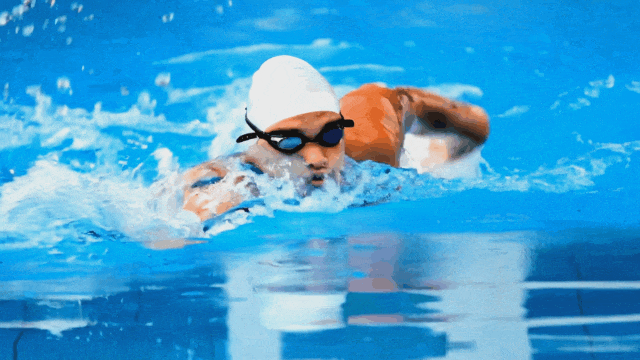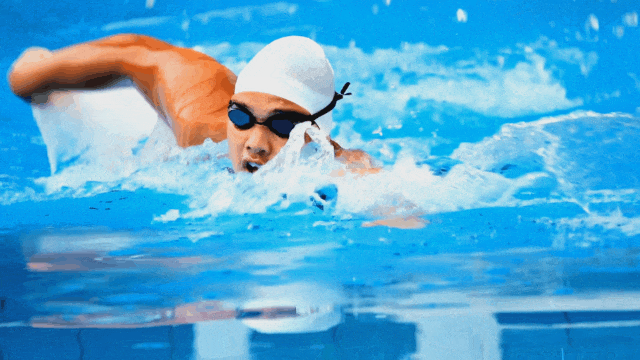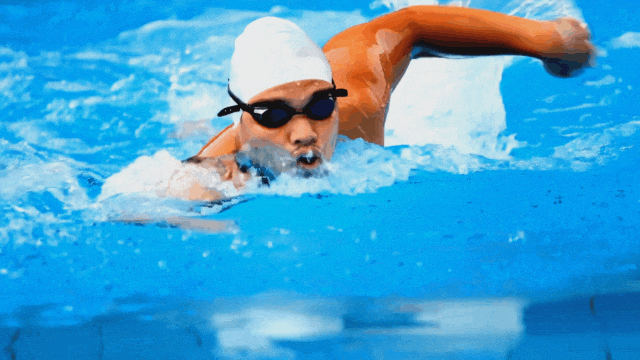
Image 16: 通义万相首创生成汉字视频,全面进化称霸VBench!AI视频GPT-3时刻来临

在泳池中,一名男子正在奋力向前游动。近景俯拍镜头下,他穿着黑色泳衣,戴着白色泳帽和黑色泳镜,正在水中划动双臂。他的头部部分被泳帽和泳镜遮挡,只露出嘴巴和鼻子。他的手臂在水中划动,产生了一系列的水花和气泡。随着他的动作,水面上出现了涟漪,水花四溅。背景是蓝色的泳池。

就看这个跳水动作,完全就是一个专业级选手的样子。肌肉的精准控制、溅起的水花,都非常符合自然规律。
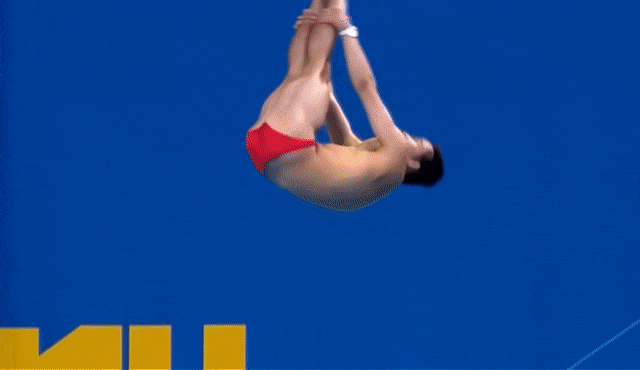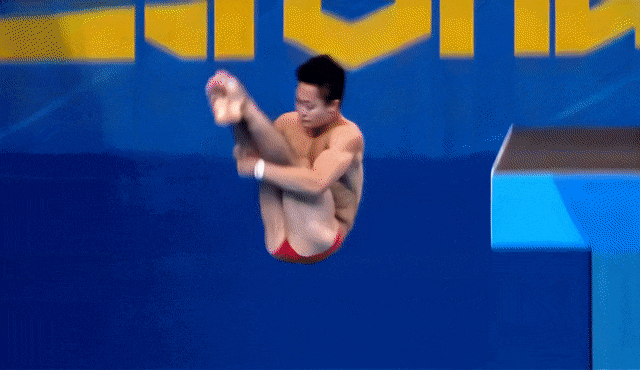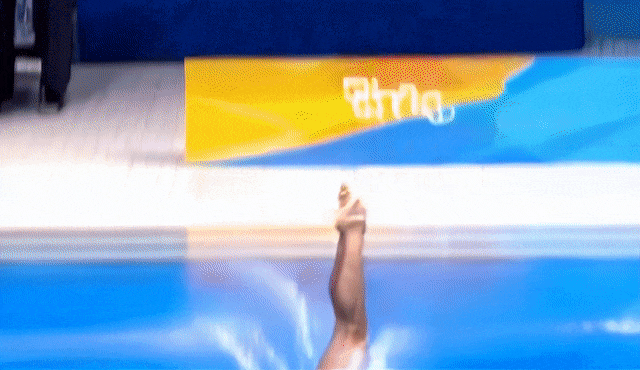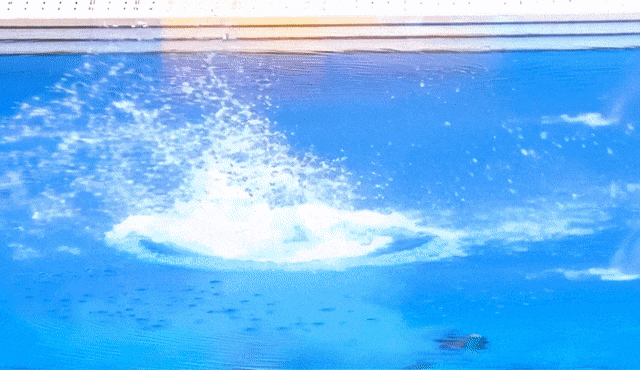
Image 17: 通义万相首创生成汉字视频,全面进化称霸VBench!AI视频GPT-3时刻来临

一名男子在跳台上做专业跳水动作。全景平拍镜头中,他穿着红色泳裤,身体呈倒立状态,双臂伸展,双腿并拢。镜头下移,他跳入水中,溅起水花。背景中是蓝色的泳池。

特写镜头下,女孩以手指轻触红唇,然后开怀大笑。这么近的怼脸特写,表情肌的走向和分布都十分自然,脸部纹路和嘴角笑起的弧线,也逼真似真人。
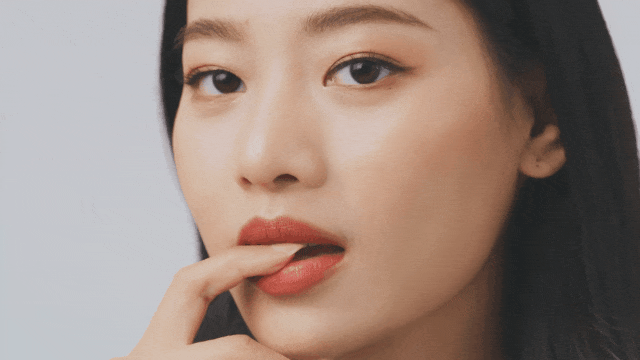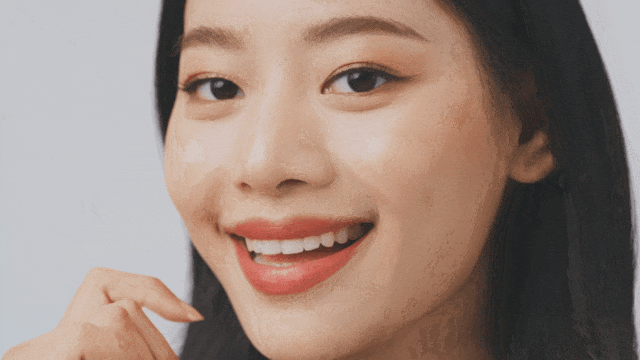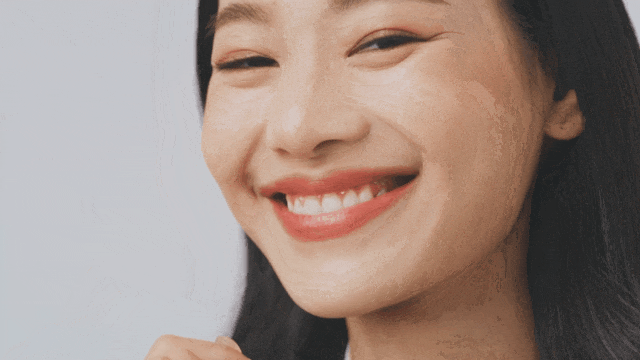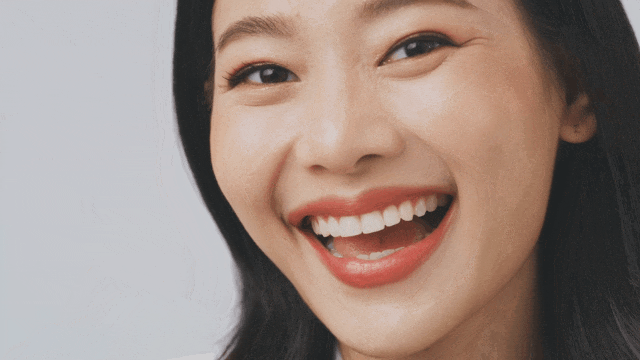
Image 18: 通义万相首创生成汉字视频,全面进化称霸VBench!AI视频GPT-3时刻来临

特写镜头下,一位美女面容精致,她先是以手指轻触红唇,微微抿嘴,眼神中透露出一丝俏皮。紧接着,她毫无保留地开怀大笑,笑容如同绽放的花朵,美丽动人,眼角弯成了月牙状,展现出无比的快乐与感染力。

3. 更灵活的运镜控制

同一个场景下的视频,为什么专业人士拍出来就是不一样?某种程度上讲,秘诀在于「运镜」。

那么,对于AI来说,教它运镜就相当于在教机器人当导演。

它需要理解跟随拍摄节奏、快慢推进速度,还要保持协调性的问题,比如镜头移动时,主体不能丢失;运镜速度变化要自然,不能忽快忽慢。

更重要的是,AI还得有艺术感,运镜效果要符合视觉习惯,动态美感要恰到好处。

在通义万相2.1版本中,AI展现出了专业级的运镜效果。

穿着禅衣的小狐狸,在360度运镜下欢快跳舞,这不,梦幻般的效果一下子就来了。
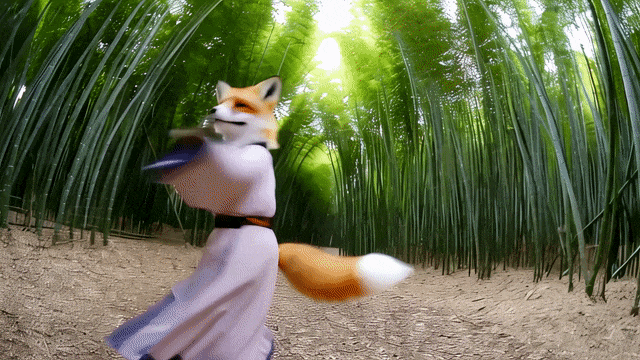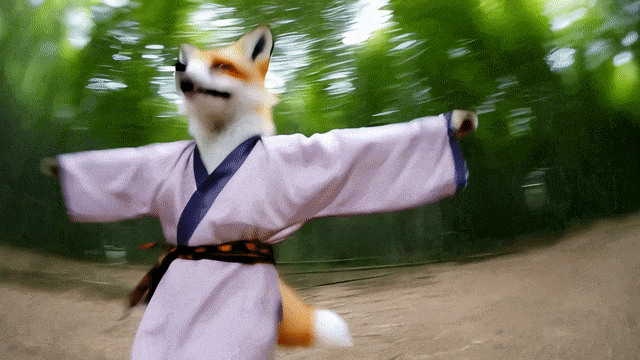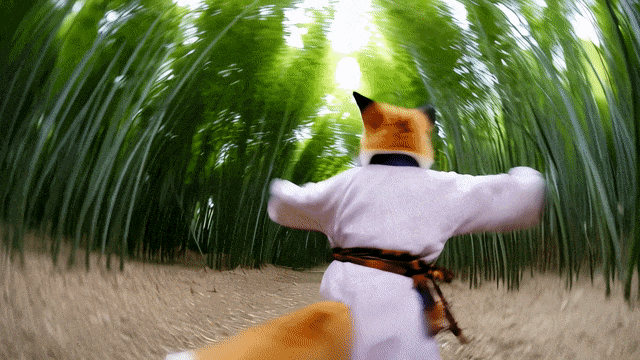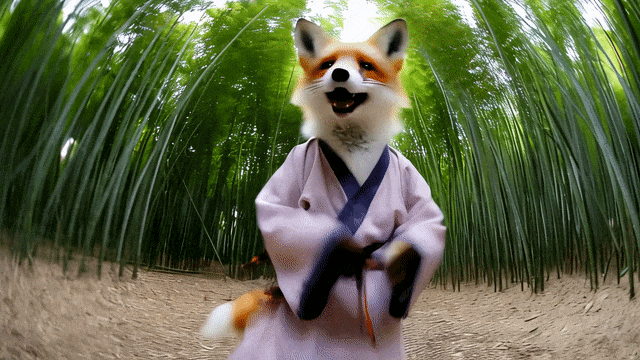
Image 19: 通义万相首创生成汉字视频,全面进化称霸VBench!AI视频GPT-3时刻来临

穿着禅意风服饰的可爱狐狸在林间空地上欢快地跳舞,身上的衣物随风轻扬。狐狸有着蓬松的尾巴和灵动的眼神,嘴角带着微笑,仿佛在享受自然的每一刻。背景是茂密的竹林,阳光透过竹叶洒下斑驳光影。画面采用旋转拍摄,营造出梦幻般的动感效果。整体风格清新自然,充满东方韵味。近景动态特写。

此外,新模型还能自动根据场景需求,智能调整运镜速度,完美把控了镜头的节奏。

海王在暴风雨中驾驭巨浪前行,这种级别的运镜绝对经得起考验,出现在大荧幕上也毫不违和。
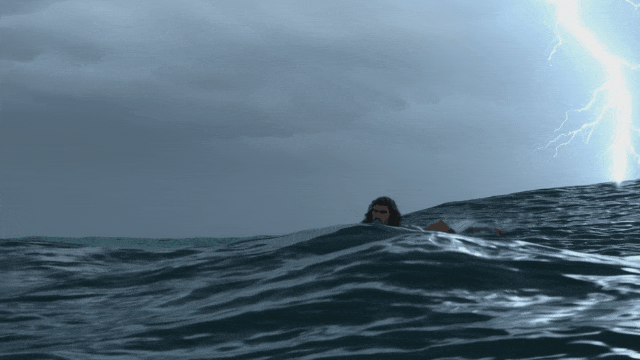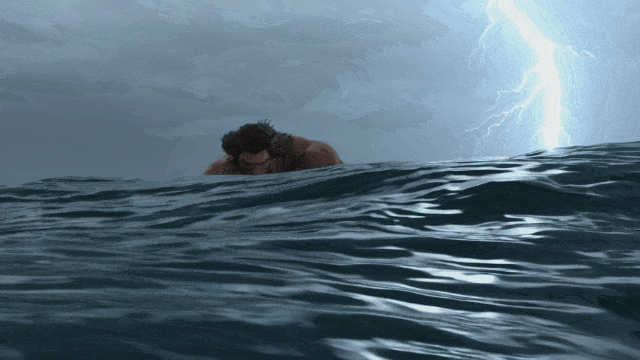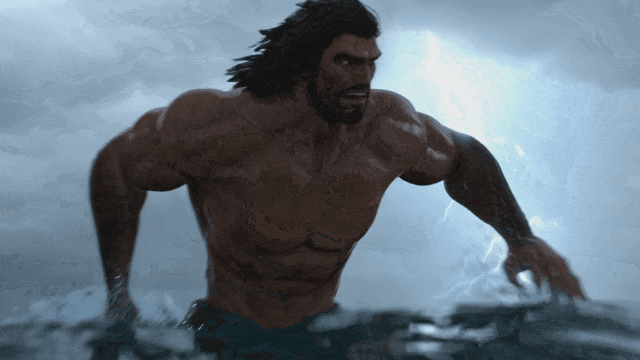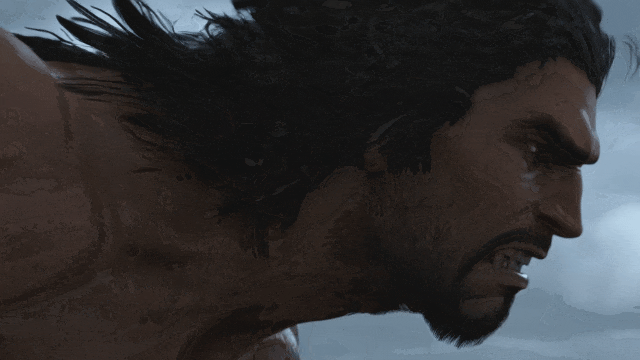
Image 20: 通义万相首创生成汉字视频,全面进化称霸VBench!AI视频GPT-3时刻来临

暴风雨中的海面,海王驾驭巨浪前行,肌肉线条,灰暗天空,戏剧性照明,动态镜头,粗犷,高清,动漫风格

实验室中女医生精心设计的特写镜头,细腻的表情刻画,以及背后灯光、实验器材等多种元素碰撞,让整个角色立即具备了丰富的层次感。
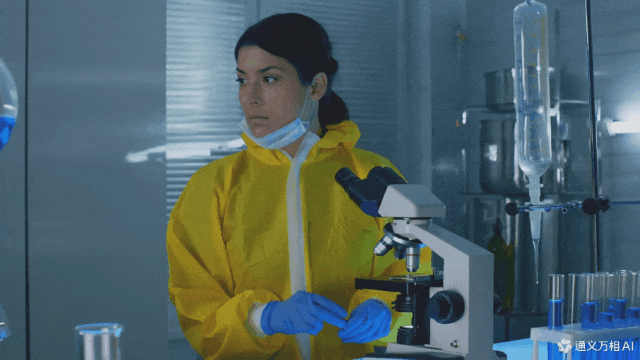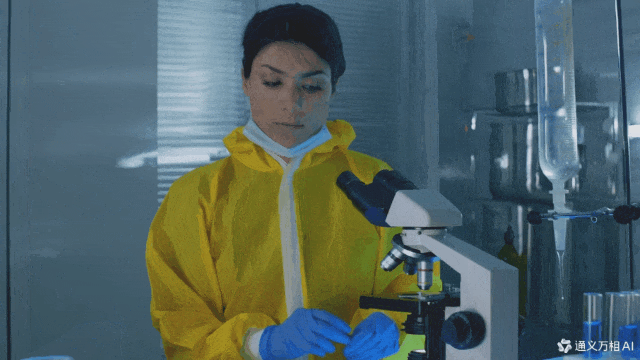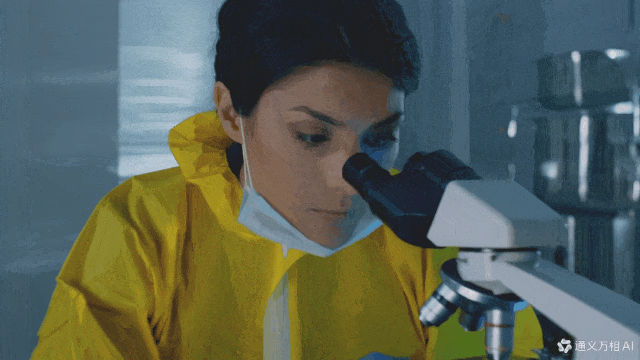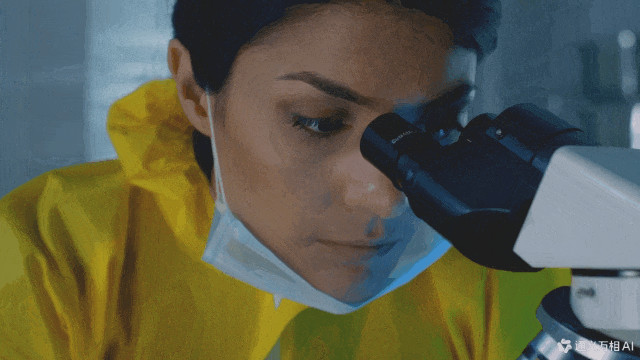
Image 21: 通义万相首创生成汉字视频,全面进化称霸VBench!AI视频GPT-3时刻来临

富有电影感的镜头捕捉了一位身着暗黄色生化防护服的女医生,实验室惨白的荧光灯将她的身影笼罩其中。镜头缓缓推进她的面部特写,细腻的横向推移凸显出她眉宇间深深刻画的忧思与焦虑。她专注地俯身于实验台前,目不转睛地透过显微镜观察,手套包裹的双手正谨慎地微调着焦距。整个场景笼罩在压抑的色调之中,防护服呈现出令人不安的黄色,与实验室冰冷的不锈钢器械相互映衬,无声地诉说着事态的严峻和未知的威胁。景深精确控制下,镜头对准她眼中流露的恐惧,完美传达出她肩负的重大压力与责任。

下面这个镜头中,穿过一条两盘种满树木的郊区住宅街道,给人一种实时拍摄的感觉。
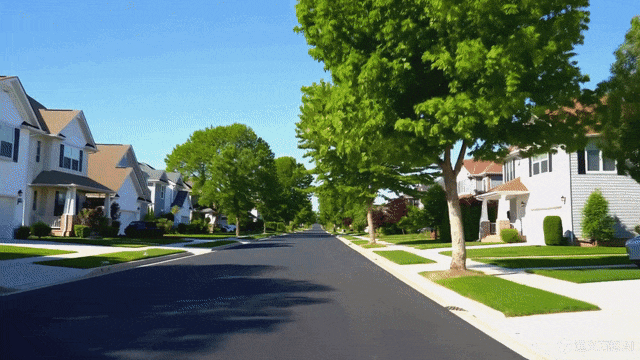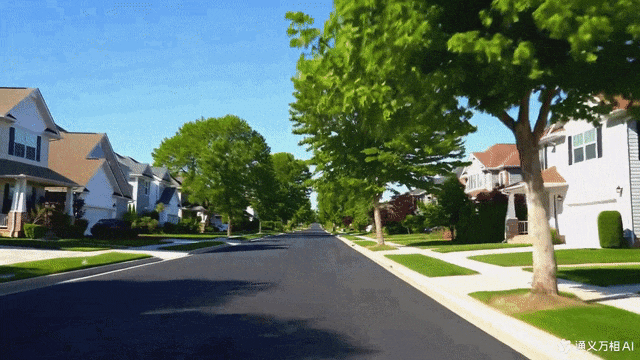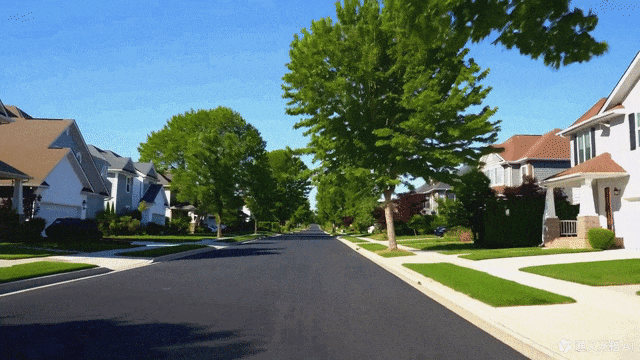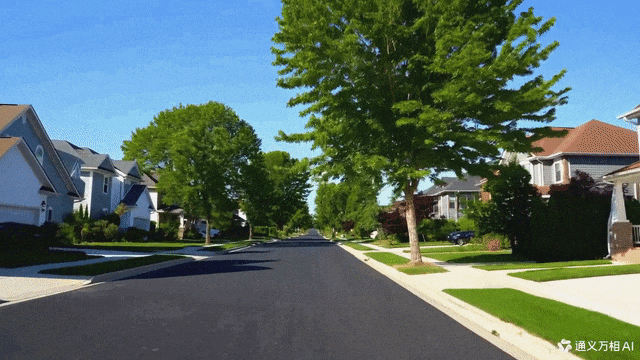
Image 22: 通义万相首创生成汉字视频,全面进化称霸VBench!AI视频GPT-3时刻来临

A fast-tracking shot down an suburban residential street lined with trees. Daytime with a clear blue sky. Saturated colors, high contrast

4. 真实的物理规律模拟

AI视频模型不理解物理世界,一直以来饱受诟病。

比如,Sora不仅会生成8条腿的蚂蚁,而且眼瞧着手都要被切断了,也切不开西红柿, 而通义万相2.1切西红柿就像发生在现实生活中一样自然真实。
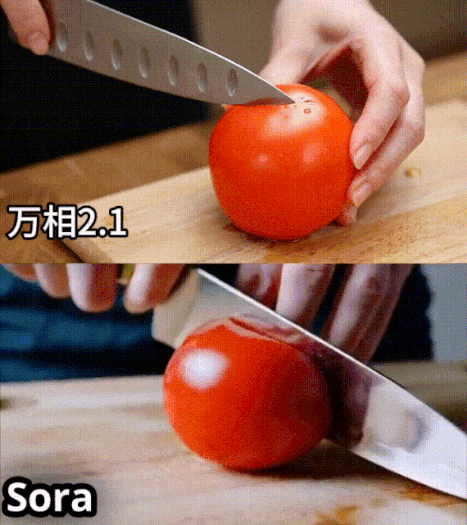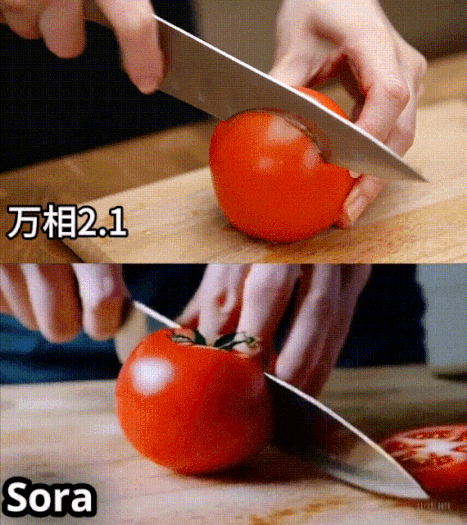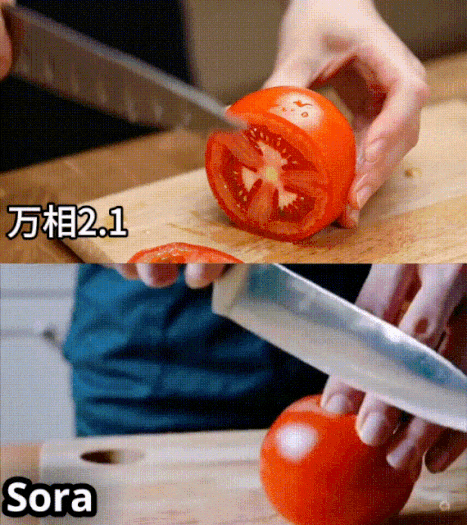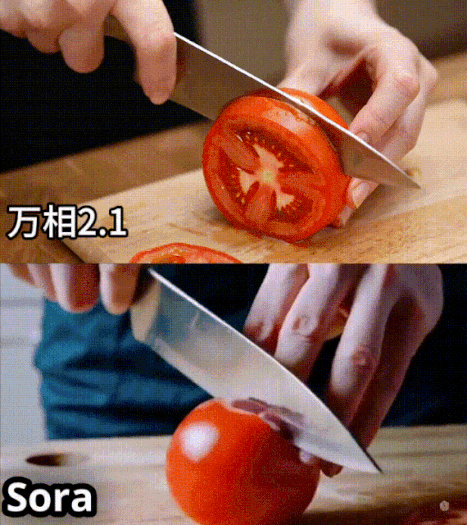
Image 23: 通义万相首创生成汉字视频,全面进化称霸VBench!AI视频GPT-3时刻来临

这一次,通义万相在物理规律理解上,得到显著提升。通过对现实世界动态和细节深入认知,就能模拟出真实感十足的视频,避免「一眼假」情况的出现。

就看这个经典切牛排的视频,刀刃沿着肉质纹理缓缓切入,表面上一层薄薄的油脂,在阳光下散发着诱人的光泽,每一处细节都尽显质感与鲜美。
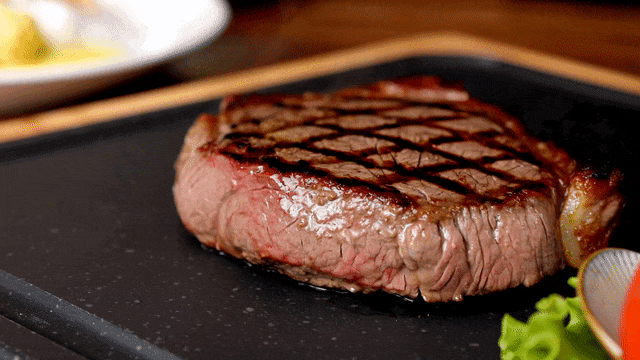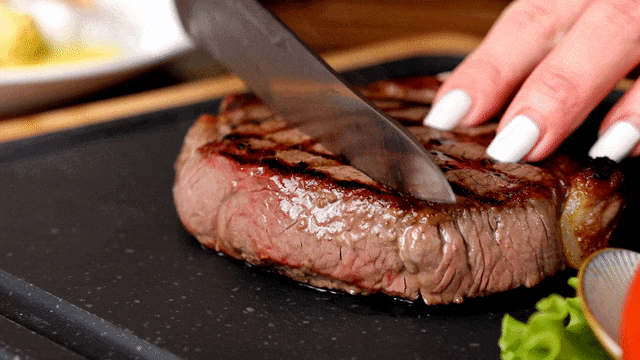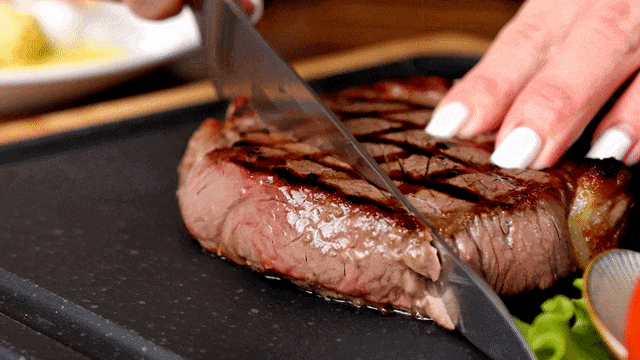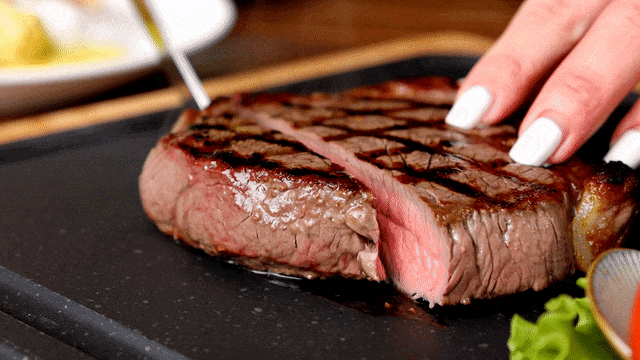
Image 24: 通义万相首创生成汉字视频,全面进化称霸VBench!AI视频GPT-3时刻来临

在餐厅里,一个人正在切一块热气腾腾的牛排。在特写俯拍下,这个人右手拿着一把锋利的刀,将刀放在牛排上,然后沿着牛排中心切开。这个人手上涂着白色指甲油,背景是虚化的,有一个白色的盘子,里面放着黄色的食物,还有一张棕色的桌子。

它具备更强大的概念组合能力,能够准确理解和整合元素级的概念,使其在生成内容时更加智能。

比如,柯基+拳击,会碰撞出什么呢?

AI生成的柯基打斗的画面,真给人一种人类拳击的现场感。
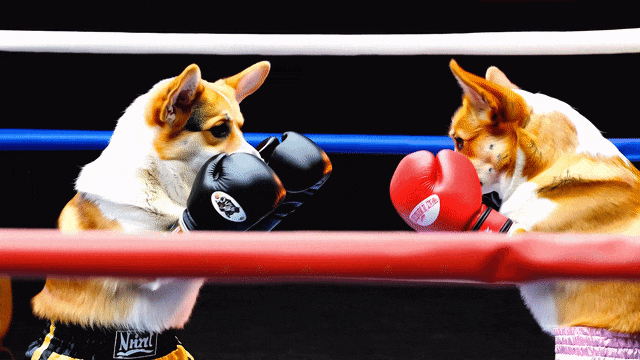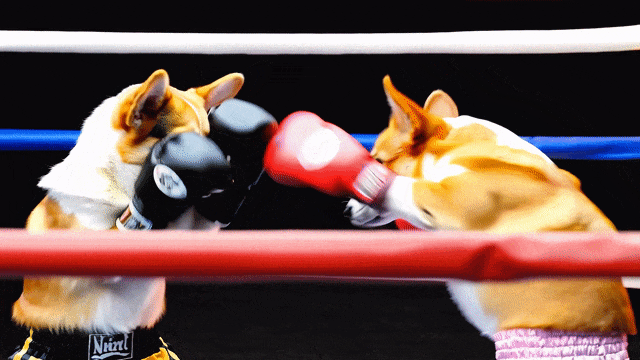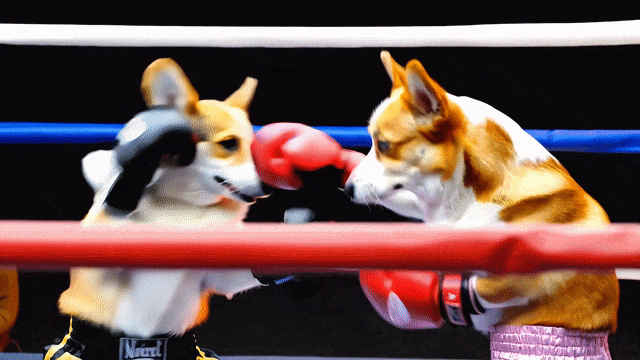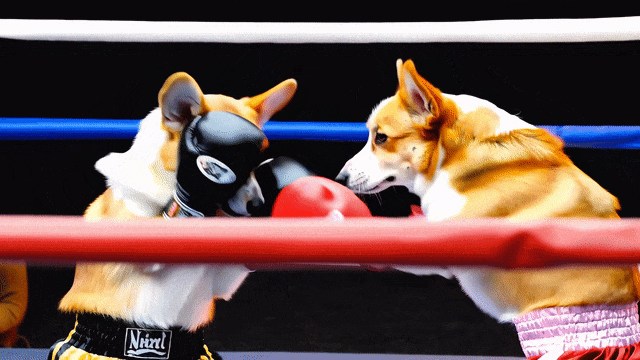
Image 25: 通义万相首创生成汉字视频,全面进化称霸VBench!AI视频GPT-3时刻来临

两只柯基狗在擂台中央进行拳击比赛。左边的狗戴着黑色拳套,右边的狗戴着红色拳套。平拍镜头下,两只狗都穿着拳击短裤,身体肌肉线条明显。它们互相挥动拳头,进行攻防转换。整个场景在固定视角下拍摄,没有明显的运镜变化。

AI大牛Karpathy最爱考验AI视频的难题,就是「水獭在飞机上用wifi」。这道题,万相2.1完美做出。
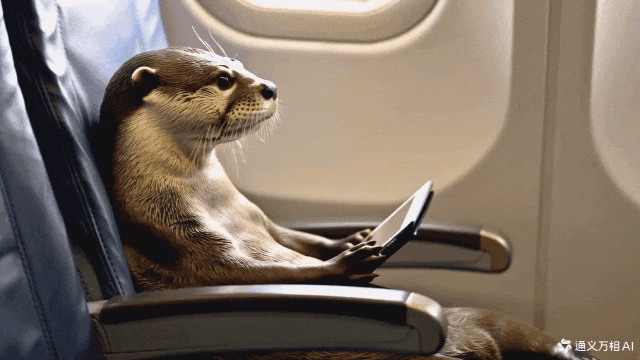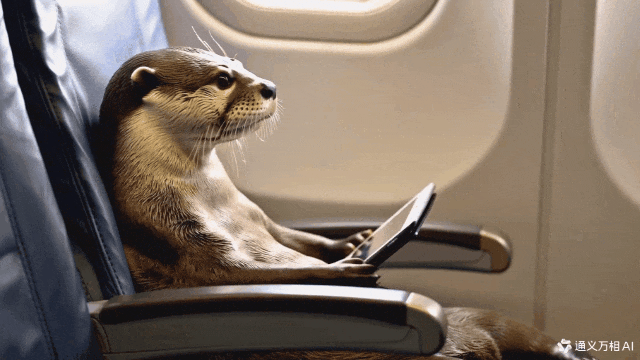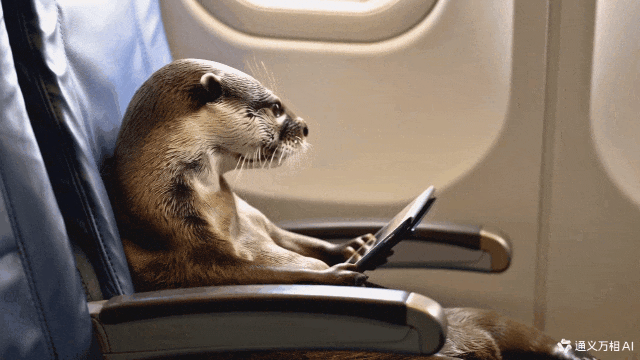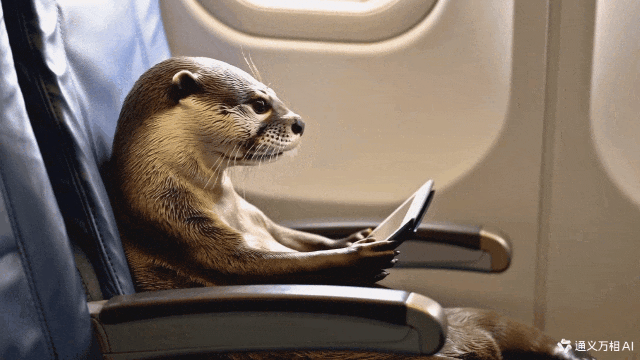
Image 26: 通义万相首创生成汉字视频,全面进化称霸VBench!AI视频GPT-3时刻来临

5. 高级质感、多种风格、多长宽比

更值得一提的是,万相2.1能够生成「电影级」画质的视频。

同时,它还能支持各类艺术风格,比如卡通、电影色、3D风格、油画、古典等等。

不论是哥特式电影风格,还是中国古典宫廷风格,AI将其特点呈现得淋漓尽致。
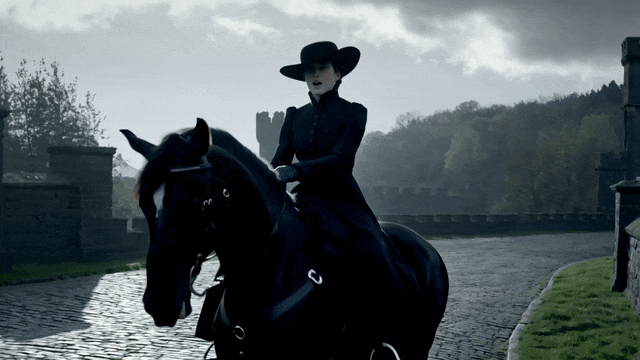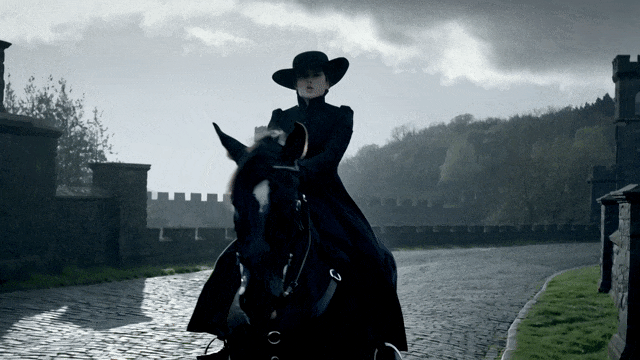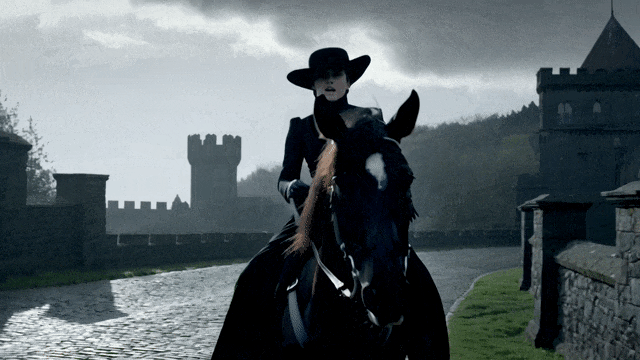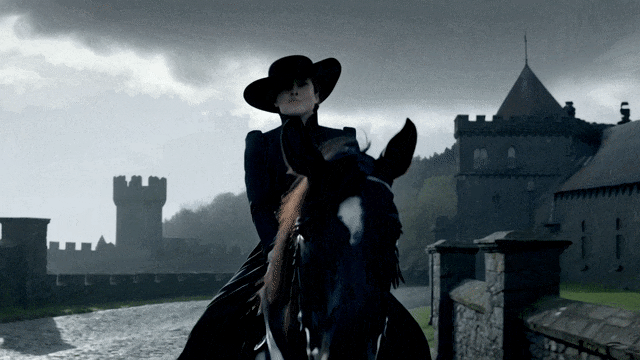
Image 27: 通义万相首创生成汉字视频,全面进化称霸VBench!AI视频GPT-3时刻来临

哥特式电影风格,亚当斯骑在一匹黑色骏马上,马蹄轻踏在古老的石板路上。她身穿黑色长裙,头戴宽边帽,眼神冷峻,嘴角微扬,透出一丝神秘。背景是阴暗的古堡和茂密的森林,天空中飘着乌云。镜头晃动,营造出一种不安与紧张的氛围。近景动态骑马场景。

这个中国古典宫廷风格的画面,镜头由群臣向前推进,聚焦在身披龙袍的皇帝身上,好像正在上映的一部古装剧。
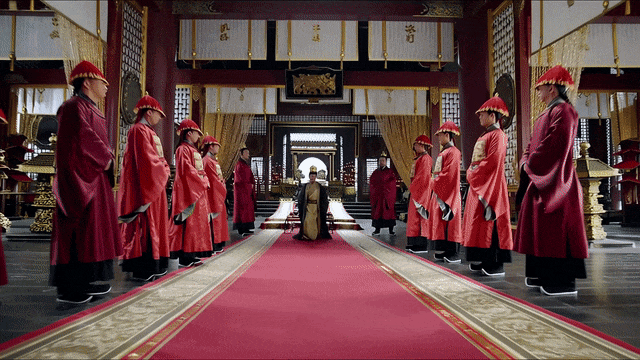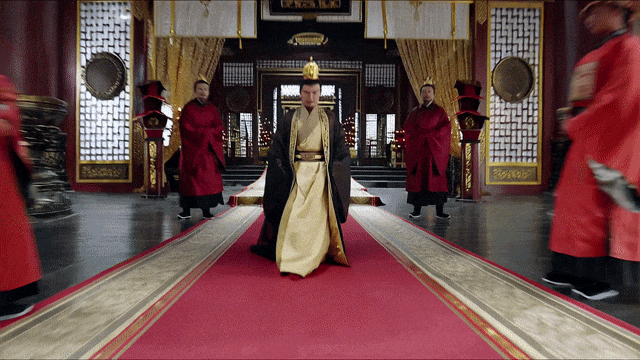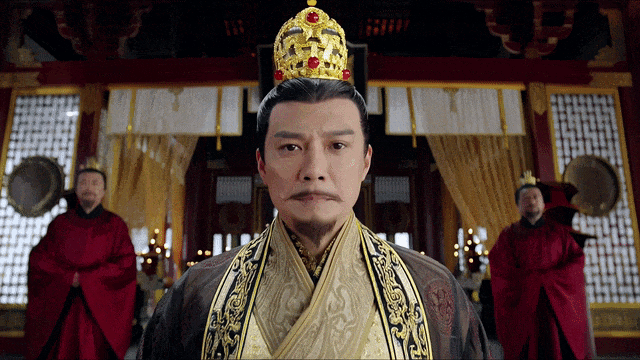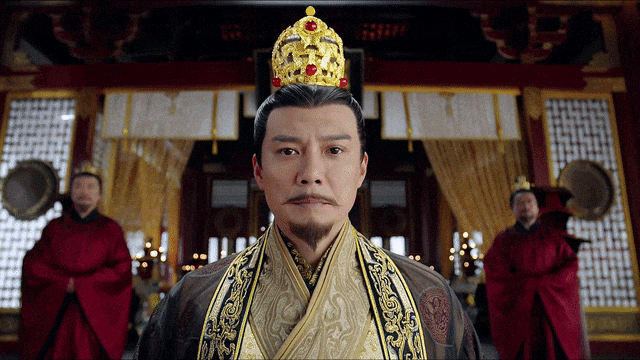
Image 28: 通义万相首创生成汉字视频,全面进化称霸VBench!AI视频GPT-3时刻来临

中国古典宫廷风格,古代皇宫宫殿上正在进行皇帝的登基大典。群臣身着华丽朝服,表情肃穆,排列整齐。镜头从群臣视角出发快速向前推进,锁定在身穿龙袍、头戴皇冠的皇帝身影上。皇帝面容威严,眼神坚定,缓缓步入大殿。背景是金碧辉煌的大殿,雕梁画栋,气势恢宏。画面带有浓厚的皇家氛围,近景特写与中景结合,快速推进和跟随拍摄。

养蜂人手中的蜂蜜罐在阳光中折射出温暖的光晕,背后的向日葵与乡村老宅相映成趣,构筑出一幅充满岁月与质感的画面。
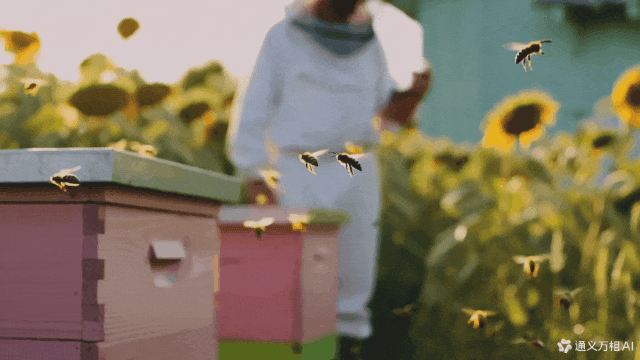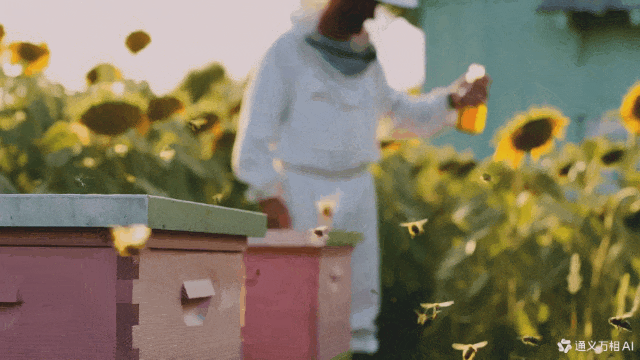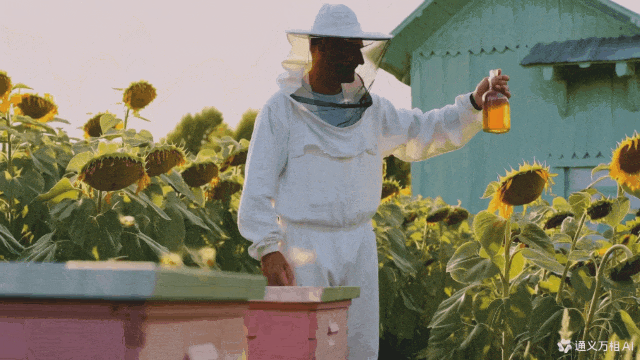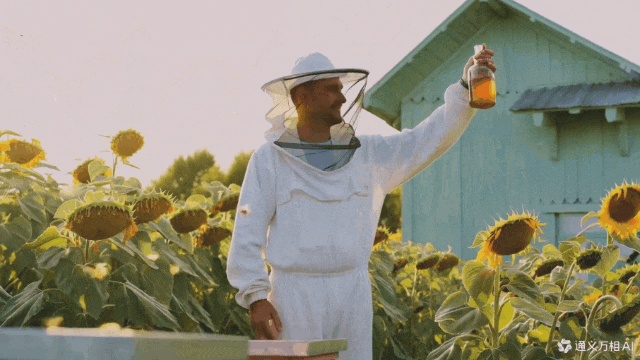
Image 29: 通义万相首创生成汉字视频,全面进化称霸VBench!AI视频GPT-3时刻来临

The camera floats gently through rows of pastel-painted wooden beehives, buzzing honeybees gliding in and out of frame. The motion settles on the refined farmer standing at the center, his pristine white beekeeping suit gleaming in the golden afternoon light. He lifts a jar of honey, tilting it slightly to catch the light. Behind him, tall sunflowers sway rhythmically in the breeze, their petals glowing in the warm sunlight. The camera tilts upward to reveal a retro farmhouse.

大文豪李白的「举头望明月,低头思故乡」,AI直接把氛围感拉满。
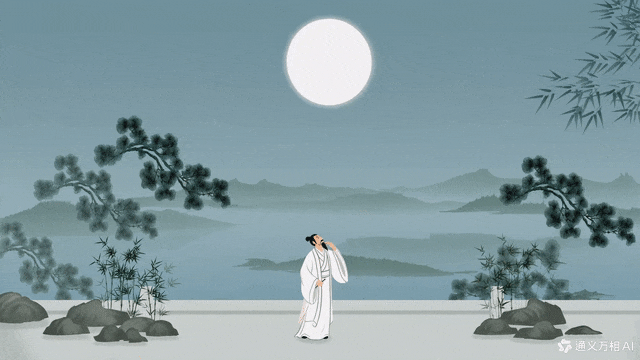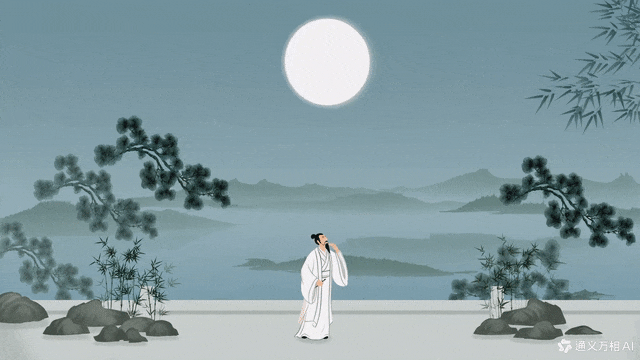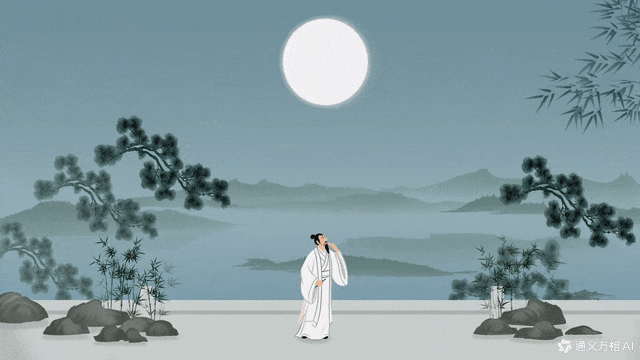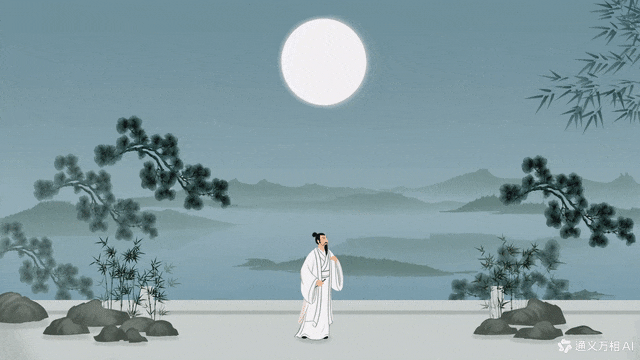
Image 30: 通义万相首创生成汉字视频,全面进化称霸VBench!AI视频GPT-3时刻来临

古风画面,一位古人抬头望着月亮,缓缓低头,眼神中流露出深深的思乡之情。

对于词穷的创意者来说,通义万相「智能体扩写」功能非常友好。比如, 我想生成一个「超快放大蒲公英,展现宏观梦幻般的抽象世界」。

若想要细节更丰富的描述,直接交给AI就好了。它会自动生成一段文案,可以直接复用,也可以二次编辑修改。
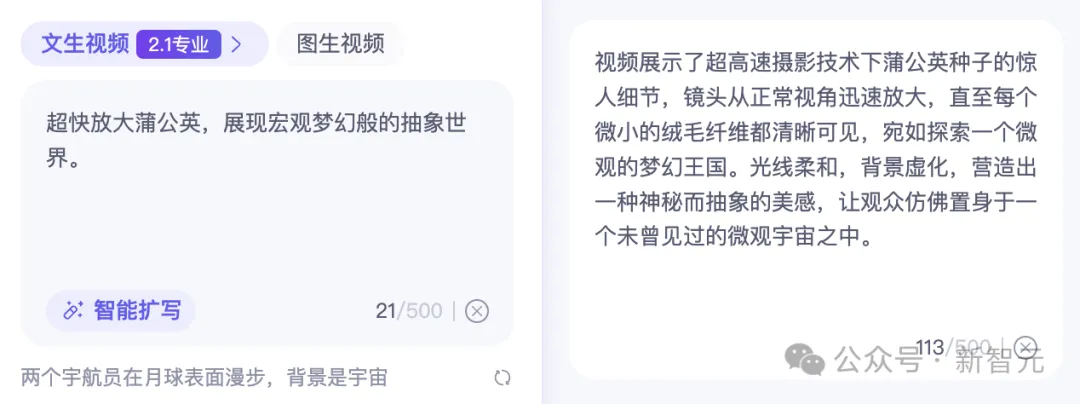
Image 31: 通义万相首创生成汉字视频,全面进化称霸VBench!AI视频GPT-3时刻来临

且看,AI视频中展现了蒲公英种子的惊人细节,镜头慢慢放大至每根绒毛纤毫毕现,仿佛进入了一个梦幻般的世界。
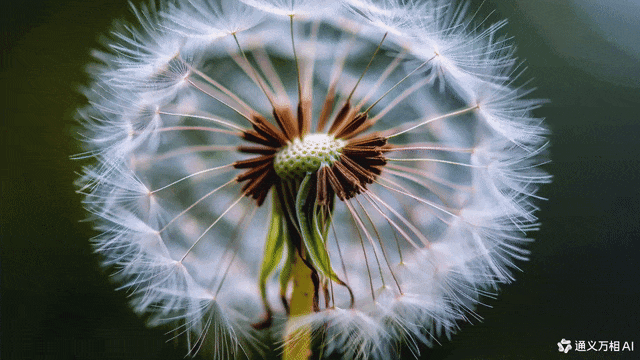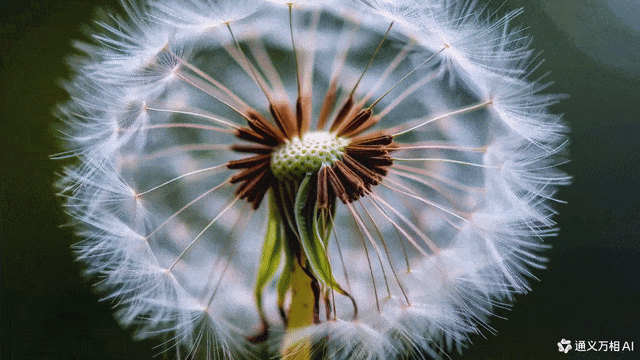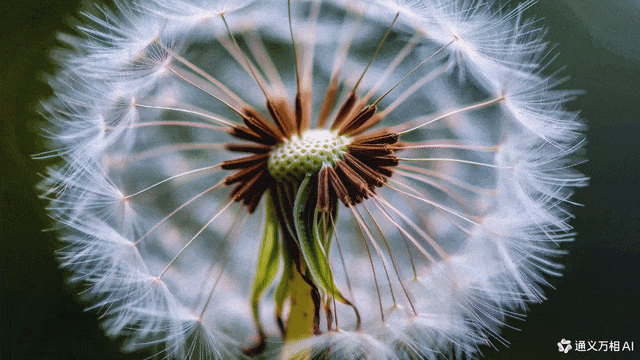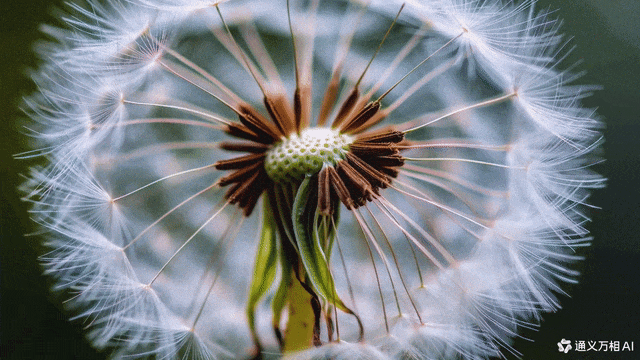
Image 32: 通义万相首创生成汉字视频,全面进化称霸VBench!AI视频GPT-3时刻来临

此外,万相2.1还能支持5种不同的长宽比——1:1, 3:4, 4:3, 16:9, 9:16,恰好可以匹配电视、电脑、手机等不同终端设备。
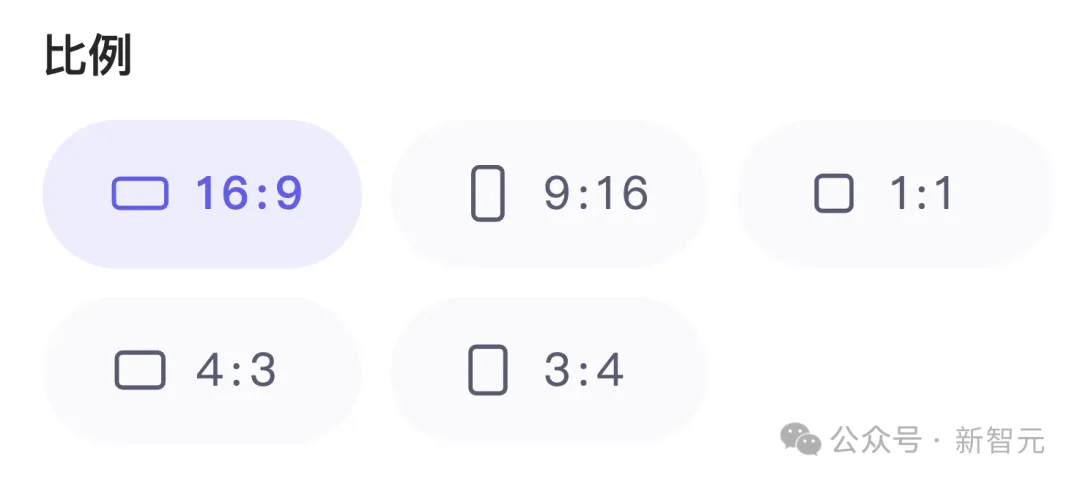
Image 33: 通义万相首创生成汉字视频,全面进化称霸VBench!AI视频GPT-3时刻来临

核心架构创新

那么,到底是什么让通义万相,能在激烈AI视频生成竞争中脱颖而出?

它又藏着哪些让人眼前一亮的「黑科技」?

接下来,让我们逐一分解此次2.1版本的技术创新突破点。

自研VAE与DiT双重突破

通过采用自研的高效VAE和DiT架构,阿里团队在时空上下文关系建模方面取得重大突破。

模型基于线性噪声轨迹的Flow Matching方案展开了深度设计,同时验证了Scaling Law在视频生成任务中的有效性。
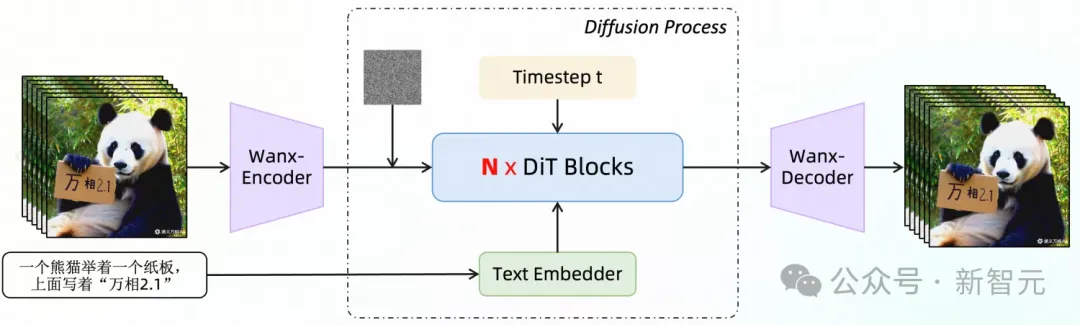
Image 34: 通义万相首创生成汉字视频,全面进化称霸VBench!AI视频GPT-3时刻来临

通义万相2.1视频生成架构图

在视频VAE层面,通过结合缓存机制和因果卷积,团队提出了一个极具创新性的视频编码解决方案。

通过将视频拆分为多个若干块(Chunk)并缓存中间特征,替代长视频的E2E编端到端解码过程。显存的使用仅与Chunk大小相关,与原始视频长度无关。

由此,这一关键技术能够支持无限长1080P视频的高效编解码,为任意时长视频训练开辟新途径。

如下图所示,展示了不同VAE模型的计算效率和视频压缩重构指标的结果。

值得一提的是,通义万相VAE在较小的模型参数规模下,取得了业内领先的视频压缩重构质量。
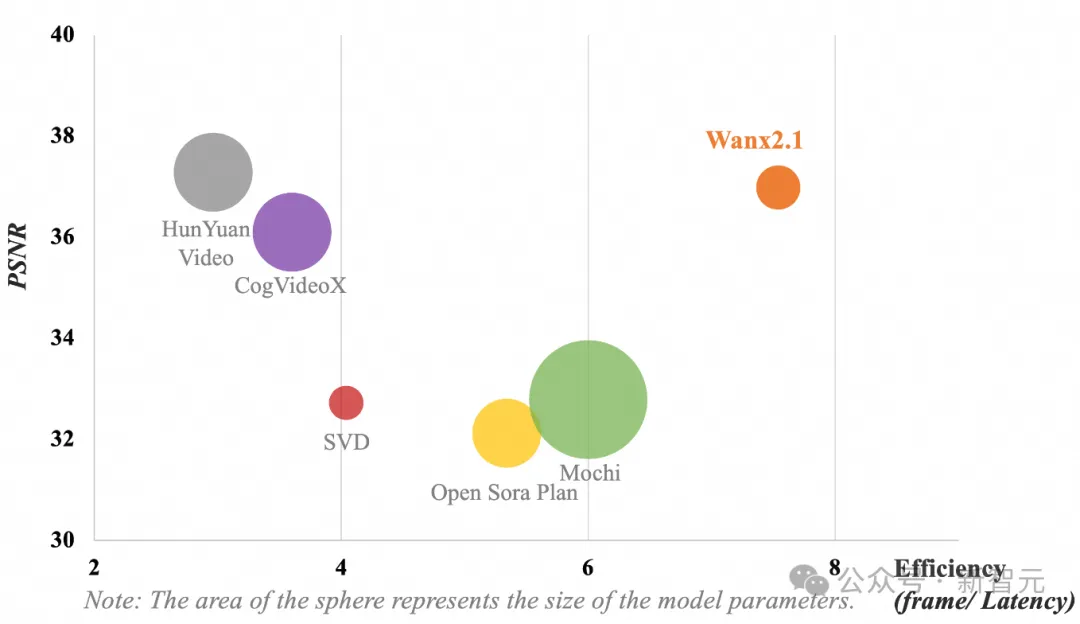
Image 35: 通义万相首创生成汉字视频,全面进化称霸VBench!AI视频GPT-3时刻来临

通义万相2.1视频VAE和其他方法的结果对比

DiT架构的设计围绕两个核心目标展开:实现强大的时空建模能力,同时保持高效的训练过程。

具体创新包括:

· 时空全注意机制

为了提高时空关系建模能力,通义万相团队采用了「时空全注意机制」,让模型能够更准确地模拟现实世界的复杂动态。

· 参数共享机制

团队引入了「参数共享机制」,不仅提升了模型性能,还有效降低了训练成本。

· 优化文本嵌入

针对文本嵌入进行了性能优化,在提供更优的文本可控性的同时,还降低了计算需求。

得益于这些创新,使得新模型在相同计算成本下,凸显出收敛的优越性,并更易实现Scaling Law的验证。

超长序列训练和推理

通过结合全新通义万相模型 Workload 的特点和训练集群的硬件性能,团队制定了训练的分布式、显存优化的策略。

这一策略在保证模型迭代时间前提下,优化训练性能,在业界率先实现了100万Tokens的高效训练。

在分布式训练策略上,团队开发了创新的4D并行策略,结合了DP、FSDP、RingAttention、Ulysses混合并行,显著提升了训练性能和分布式扩展性。
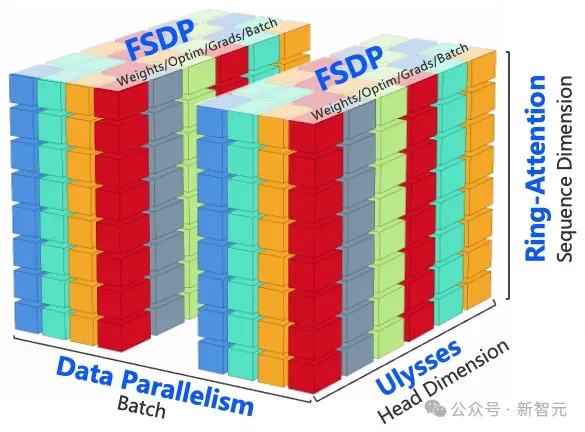
Image 36: 通义万相首创生成汉字视频,全面进化称霸VBench!AI视频GPT-3时刻来临

通义万相4D并行分布式训练策略

在显存优化上,采用了分层显存优化策略优化Activation显存,解决了显存碎片问题。

在计算优化上,使用FlashAttention3进行时空全注意力计算,并结合训练集群在不同尺寸上的计算性能,选择合适的CP策略进行切分。

同时,针对一些关键模块,去除计算冗余,使用高效Kernel实现,降低访存开销,提升了计算效率。

在文件系统优化上,结合了阿里云训练集群的高性能文件系统,采用分片Save/Load方式,提升了读写性能。

在模型训练过程中,通过错峰内存使用方案,能够解决多种OOM问题,比如由Dataloader Prefetch 、CPU Offloading 和 Save Checkpoint所引起的问题。

在训练稳定性方面,借助于阿里云训练集群的智能化调度、慢机检测,以及自愈能力,能在训练过程中实现自动识别故障节点并快速重启任务。

规模化数据构建管线与模型自动化评估机制

规模化的高质量数据是大型模型训练的基础,而有效的模型评估,则指引着大模型训练的方向。

为此,团队建立了一套完整的自动化数据构建系统。

该管线在视觉质量、运动质量等方面与人类偏好分布高度一致,能够自动构建高质量的视频数据,同时还具备多样化、分布均衡等特点。

针对模型评估,团队还开发了覆盖多维的自动化评估系统,涵盖美学评分、运动分析和指令遵循等20多个维度。

与此同时,训练出专业的打分器,以对齐人类偏好,通过评估反馈加速模型的迭代优化。

AI视频生成下一个里程碑

去年12月,OpenAI和谷歌相继放出Sora、Veo 2模型,让视频生成领域的热度再一次升温。

从创业新秀到科技巨头,都希望在这场技术革新中寻找自己的位置。

但是相较于文本的生成,制作出令人信服的AI视频,确实是一个更具挑战性的命题。

Sora正式上线那天,奥特曼曾表示,「它就像视频领域的GPT-1,现在还处于初期阶段」。
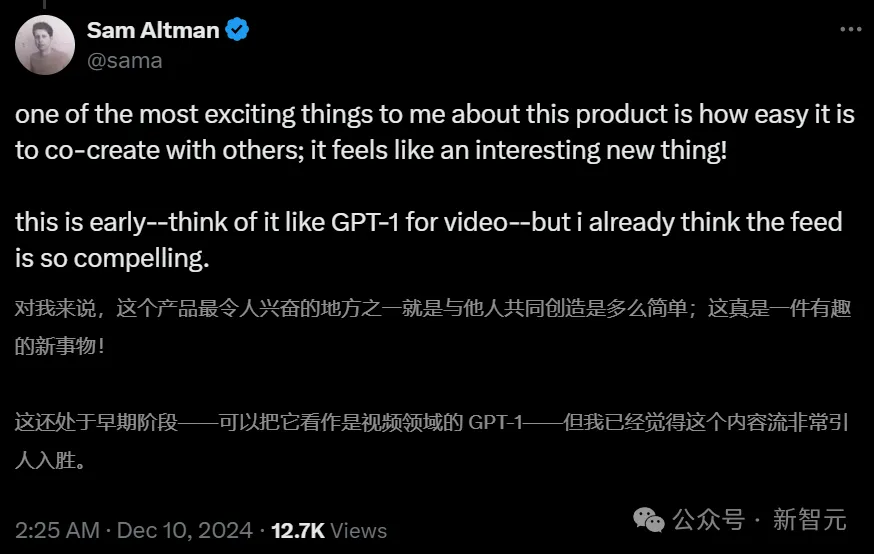
Image 37: 通义万相首创生成汉字视频,全面进化称霸VBench!AI视频GPT-3时刻来临

若要从GPT-1通往GPT-3时刻,还需要在角色一致性、物理规律理解、文本指令精准控制等方面取得技术突破。

当AI真正打破现实创作的局限,赋予创意工作者前所未有的想象,新一轮的行业变革必将随之而来。

此次,通义万相2.1取得重大突破,让我们有理由相信,AI视频的GPT-3时刻正加速到来。

参考资料:

https://tongyi.aliyun.com/wanxiang/videoCreation

文章来自于“新智元”,作者“编辑部 HYZ”。